日志的故事
Table of Contents
1. 楔子:日志的诞生
日志不是为了历史而生的。它是为了查问题。
1970 年代末,Eric Allman 在伯克利写 Sendmail,一个帮人发信的 Agent 程序,并不比现在 Code Agent 简单。
Figure 1: Eric Allman 2018
Sendmail 要在复杂的网络环境中传输邮件——连接超时、被拒收、路由失败——这些事必须记下来,否则出了问题谁都不知道发生了什么。于是 Allman 顺手写了一个子系统:syslog。
这就是日志的起点。不是理论推导,不是架构设计,是"我的程序需要告诉我它为什么失败了"。
syslog 的设计极简:程序往 /dev/log(Unix 域套接字)或 UDP 514 写一行文本,syslogd 按 facility(来源类型)和 priority(严重级别)分类写到文件里。没了。没有过滤,没有路由逻辑,没有结构化输出。
2001 年,RFC 3164 以"描述性而非规范性"的姿态记录了 BSD syslog 协议——人们早已这样做了十年,RFC 不过是追认。
这就是 sysklogd 的"半服务化"设计:它只做了半件事——收和写,中间的处理完全是硬编码的。
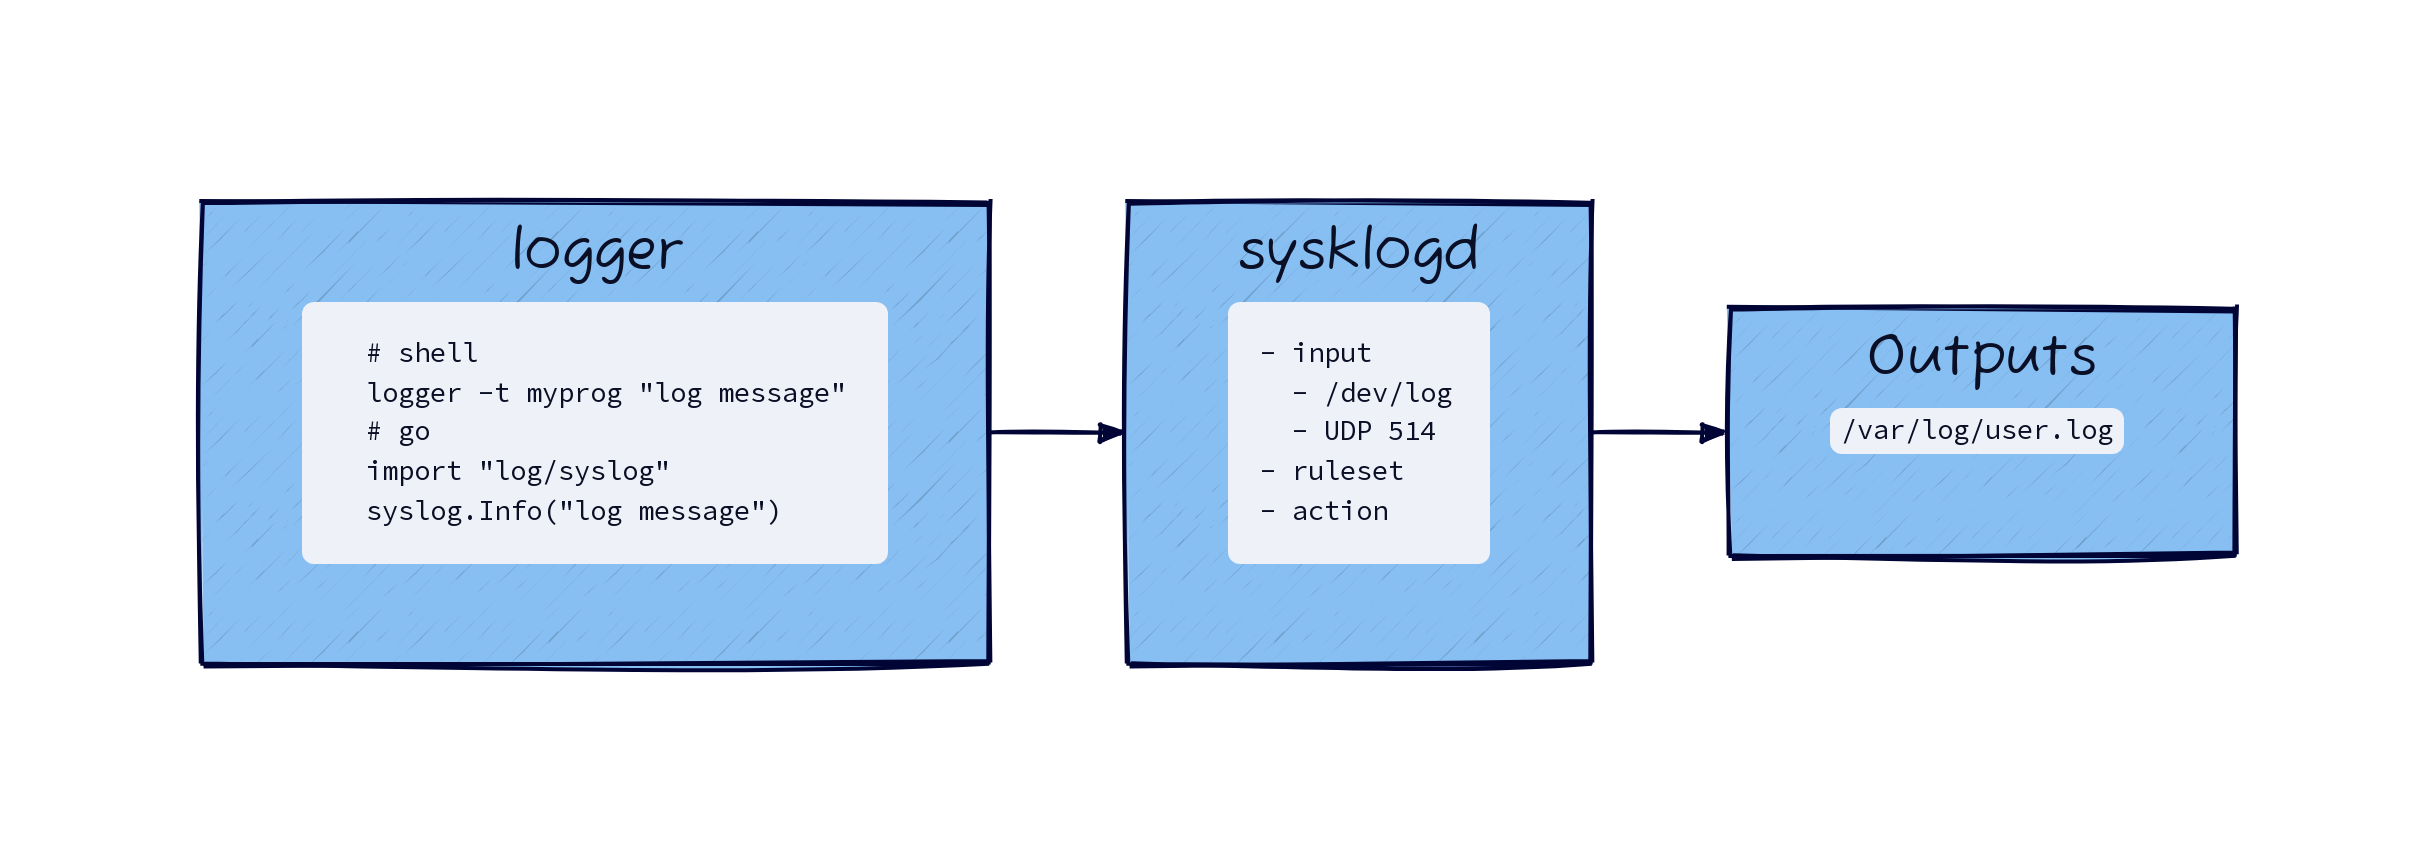
这个设计在当时足够好。单机场景下,facility/priority 两级分类法大致够用。但互联网来了,分布式系统来了,单机日志、两级分类、UDP 丢包不负责——syslog 开始卡住所有人的喉咙。
日志的故事就此展开。它不是一条平滑的演化曲线,而是一连串"解决问题又制造问题"的循环。每个时代的工程师都以为找到了最终答案,但下一代总是发现他们忽略了一个根本假设。
2. 第一幕:黎明时代的破冰者
syslog-ng 和 rsyslog 是第一波真正动手改造 syslog 的人。他们带来了基于内容的过滤、模块化架构、编程能力的配置语言——每一项都是对 sysklogd " 半服务化"设计的突破。
但他们所有的创新都围绕同一个假设展开:日志需要一个长期运行的守护进程来接管。这个假设在 2000 年代如此自然,以至于没有人质疑——直到 Docker 把它连根拔掉。
2.1. 先行者:syslog-ng(约 1998)
第一个打破僵局的是 Balázs Scheidler 在匈牙利写的 syslog-ng。
Figure 2: Balázs Scheidler
syslog-ng 引入了当时革命性的能力:基于消息内容的过滤。你可以根据程序名、正则表达式决定日志的去向。它支持宏(macros),可以用 $PROGRAM、 $HOSTNAME 等变量动态生成文件名。今天看来稀松平常,在当时是石破天惊——syslog 管理员终于不用把所有日志塞进 /var/log/messages 然后靠 grep 大海捞针了。
但 syslog-ng 只往前走了一步。它解决了过滤问题,但架构仍然是 monolith。
2.2. 雷纳·格哈茨的日志之旅
雷纳·格哈茨(Rainer Gerhards)的入场方式和 Allman 很像:遇到了问题,自己动手。
他出生在德国一个靠煤矿和农业为生的小镇。在计算机出现之前,他原本注定要成为一名煤矿工人。
Figure 3: 雷纳·格哈茨与父母
17 岁时他告诉朋友:“总有一天,我会轻松地与地球上任何地方的任何人协作。”大多数人觉得他疯了——那时候连调制解调器连接都贵得吓人。
他没有机会上大学,但命运之手让他做了一份包含大量 IT 成分的工商管理工作。他爱上了公司那台 Unisys 1100 大型机。"公司几乎赶不走我。"
此后他辗转咨询行业,创办了自己的软件公司。在一次系统故障排查中,他接触到了日志,并编写了历史上第一个 Windows syslog 服务器,发明了事件日志转发技术。
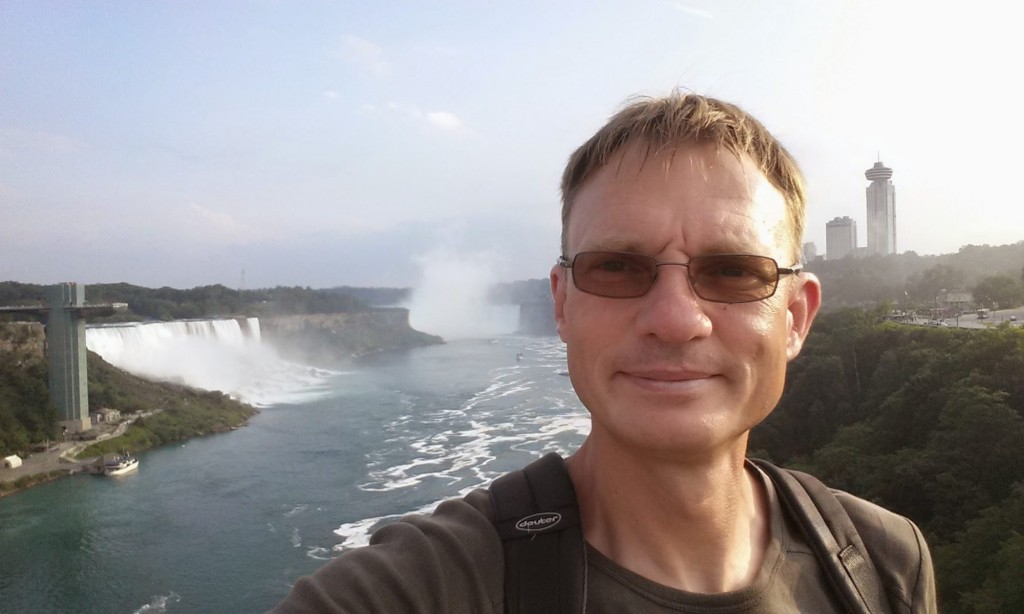
Figure 4: Rainer Gerhards 在尼亚加拉大瀑布
2.3. rsyslog:从宠物项目到行业标杆
2004 年,雷纳需要将 syslog 与数据库集成。sysklogd 做不到。他 fork 了它,创建了"个人的宠物项目"。rsyslog 诞生了。
"天啊,那真是太酷了……我做对了某件事,人们对 rsyslog 的兴趣铺天盖地。"
雷纳大概很早,至少早于 1996 年,就完全明白了 sysklogd 以及 BSD syslog 的"半服务化"设计。他据此提出了消息管道隐喻(Message Pipeline Metaphor)架构:
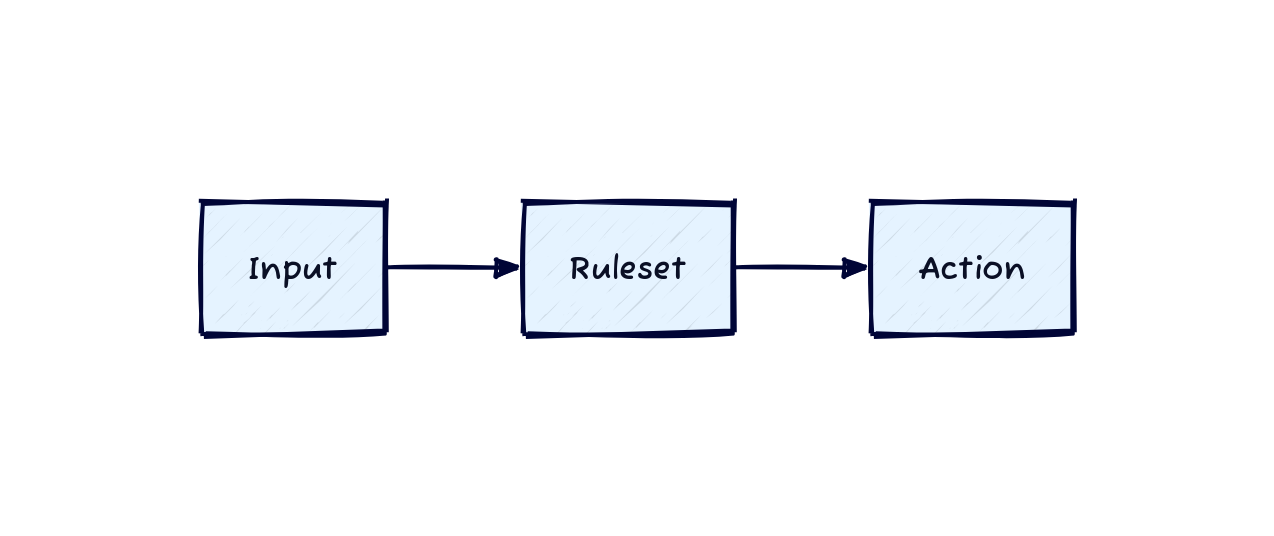
Figure 5: 消息管道隐喻架构
这个架构的突破性在于:把日志处理分解为三个阶段——接收(Input)、路由决策(Ruleset)、输出(Action)。每个阶段都可以独立扩展。
1996 年他在 Windows 上实现 WinSyslog 时就包含了这个架构:
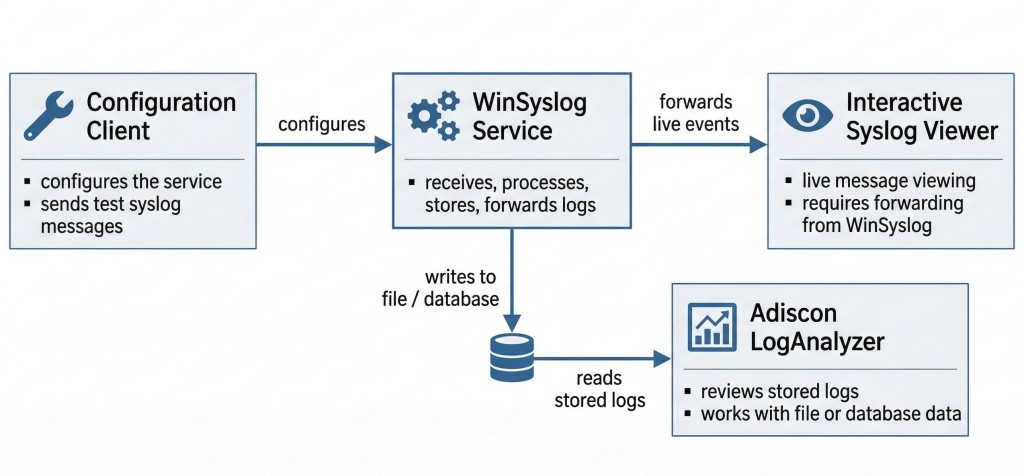
Figure 6: WinSyslog 组件架构
其中已经包含了日后 ELK 架构的影子。
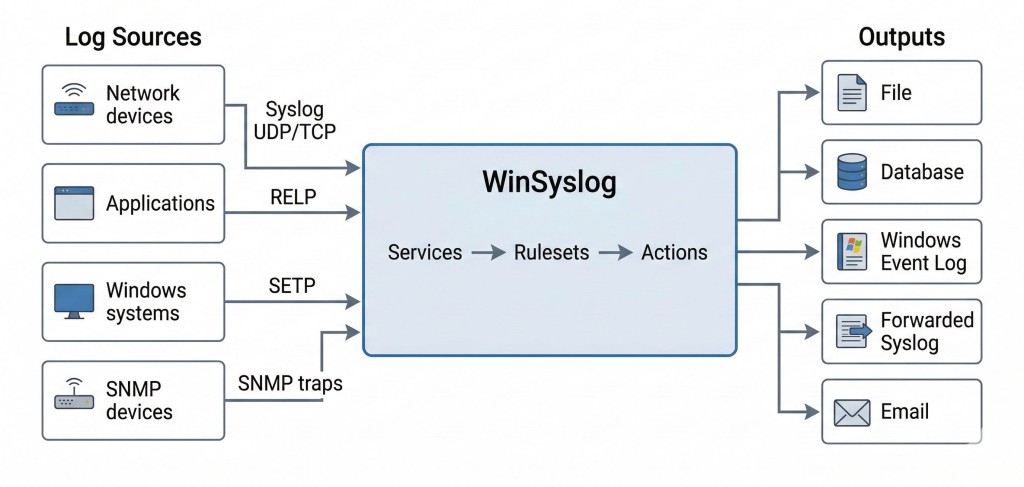
Figure 7: WinSyslog Receive Logs
注意其中的 RELP(Reliable Event Logging Protocol),是对 Syslog TCP 可靠传输的增强。总结 sysklogd 缺乏的能力:
- 可靠的消息传输(TCP,后来是 RFC 3195)
- 结构化且灵活的日志输出格式
- 为日志分析提供数据库集成
- 更好的性能和可扩展性
rsyslog 的模块化架构( im/om 输入输出模块)让系统具备了真正的可插拔能力。RainerScript——雷纳以自己名字命名的配置语言——赋予了路由完整的编程能力:变量、条件判断、循环、自定义函数,可以基于消息任意属性做复杂路由决策。这种灵活度在当时的 syslog 生态中前所未有。
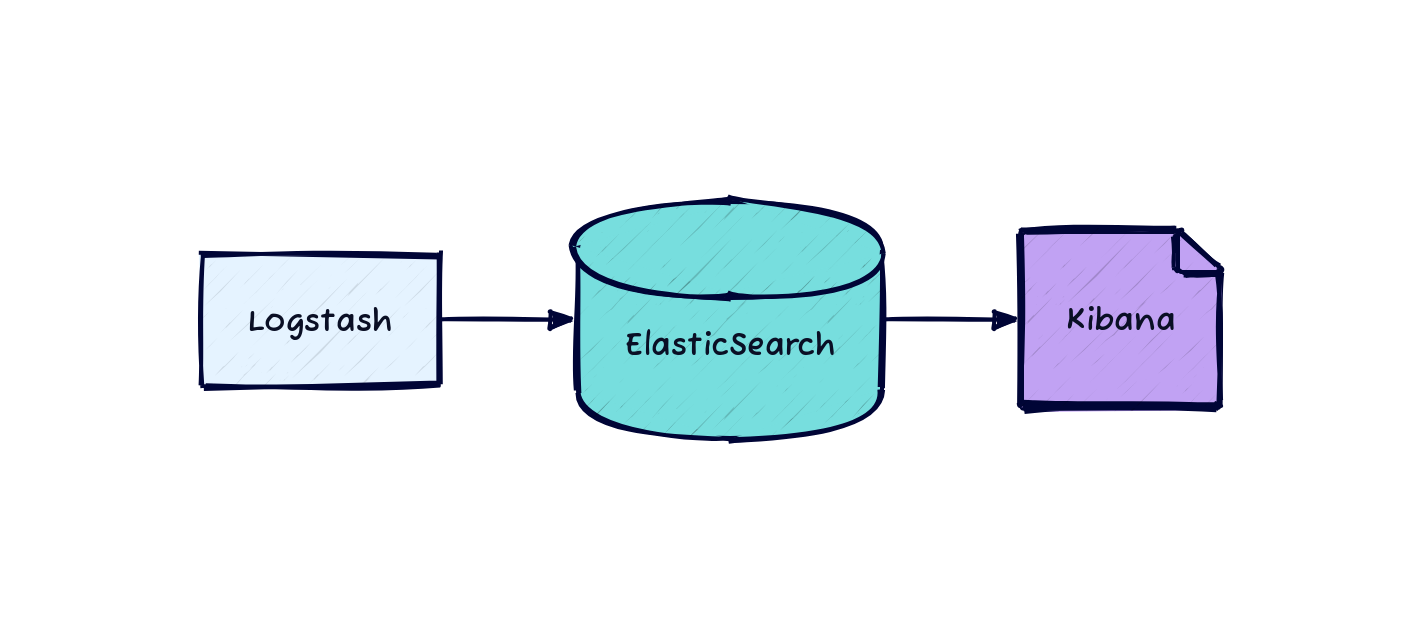
Figure 8: ELK 架构
2.4. 这一代的边界
多年后回头看这些旧事,觉得前辈们没有得要领。他们知道可靠的重要性,知道结构化输出的重要性,知道数据库集成的重要性,知道性能和可扩展的重要性,觉得解决了这几个重要问题就进入"下一代"。但他们没有意识到自己的所有努力都建立在一个隐含前提之上:系统中有一个长期运行的日志守护进程,所有日志最终都汇聚于此。
3. 第二幕:云原生浪潮的冲刷
Docker 从诞生那天就终结了"系统日志守护进程"范式。容器里没有 syslogd, PID 1 就是应用本身,标准输出取代了 /dev/log。日志不再是守护进程"收"的,而是平台层"采集"的。
这一幕围绕一个核心问题展开:当"永远在线"的守护进程消失了,日志该由谁来收?往哪里送?怎么查?
3.1. 灯下黑其一:系统之盲
所谓灯下黑其一,做复杂系统的执着于系统。rsyslog 的所有设计都围绕"系统守护进程"这个假设展开——Input(接收日志)、Ruleset(路由决策)、 Action(写入目标),一切都是守护进程内部的事。它把自己做成了日志处理的操作系统。
看破这一点的是 Docker。
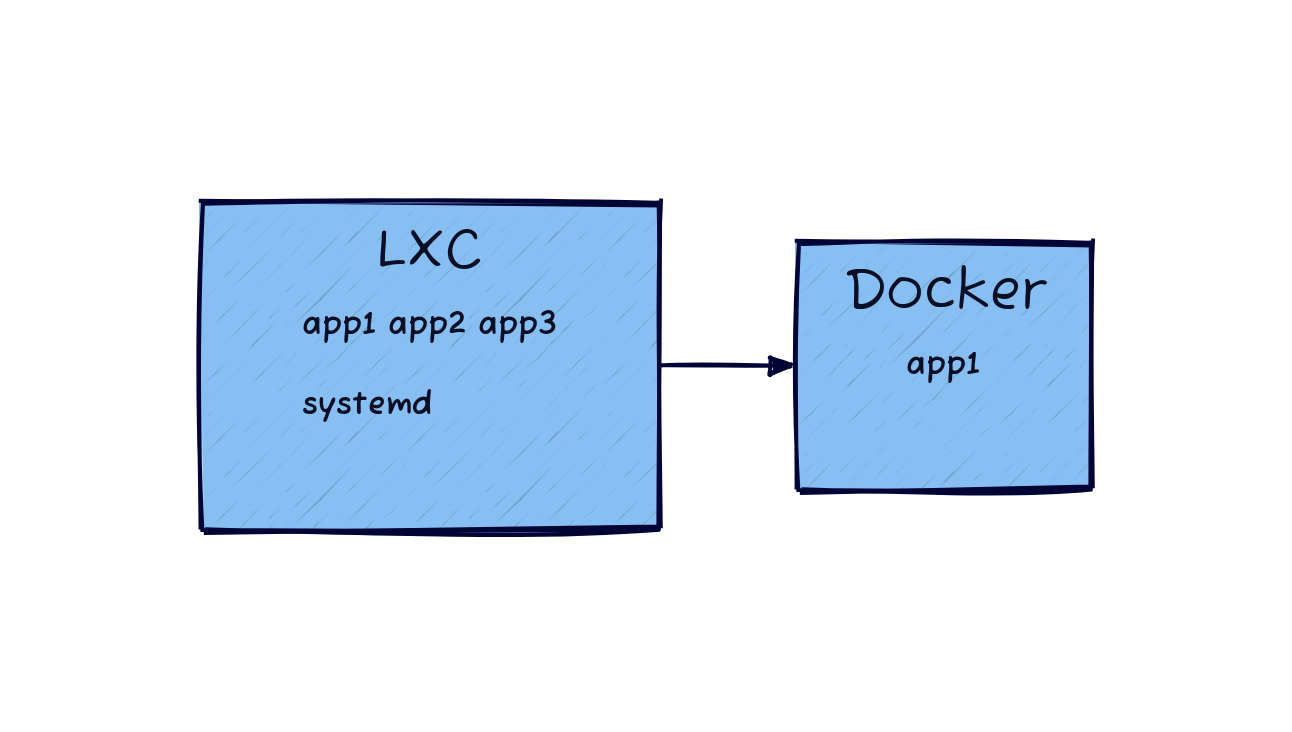
Docker 劈手把"系统"从容器切掉。容器里的 PID 1 就是应用本身,没有 systemd,没有 syslog 守护进程。应用的标准输出就是日志。日志不再是守护进程收的,是平台层采集的。rsyslog 里的"系统"虚化了。
这不是 rsyslog 的失败,而是整个"系统日志守护进程"范式的终结。Docker 不关心你的路由规则有多灵活——它根本不让你有机会运行那些规则。
3.2. 灯下黑其二:数据库之盲
所谓灯下黑其二,存放日志的数据库早不是之前的关系型数据库。这条路前辈们从未涉及,以至于山中无老虎,猴子称霸王,Elasticsearch 横空出世。
Elasticsearch 远不是适合日志存放的地方。成本太高,写放大严重,存储效率远不如专门的时序数据库。但它有一个杀手级能力——全文搜索。当你要在 TB 级的日志中找出"昨天下午三点所有返回 500 的请求",Elasticsearch 的倒排索引比任何关系型数据库都快得多。
日志的查询需求压过了一切。成本是后话。
3.3. ELK 栈的崛起
ELK 栈(Elasticsearch + Logstash + Kibana)里的 Logstash 取代了 rsyslog:
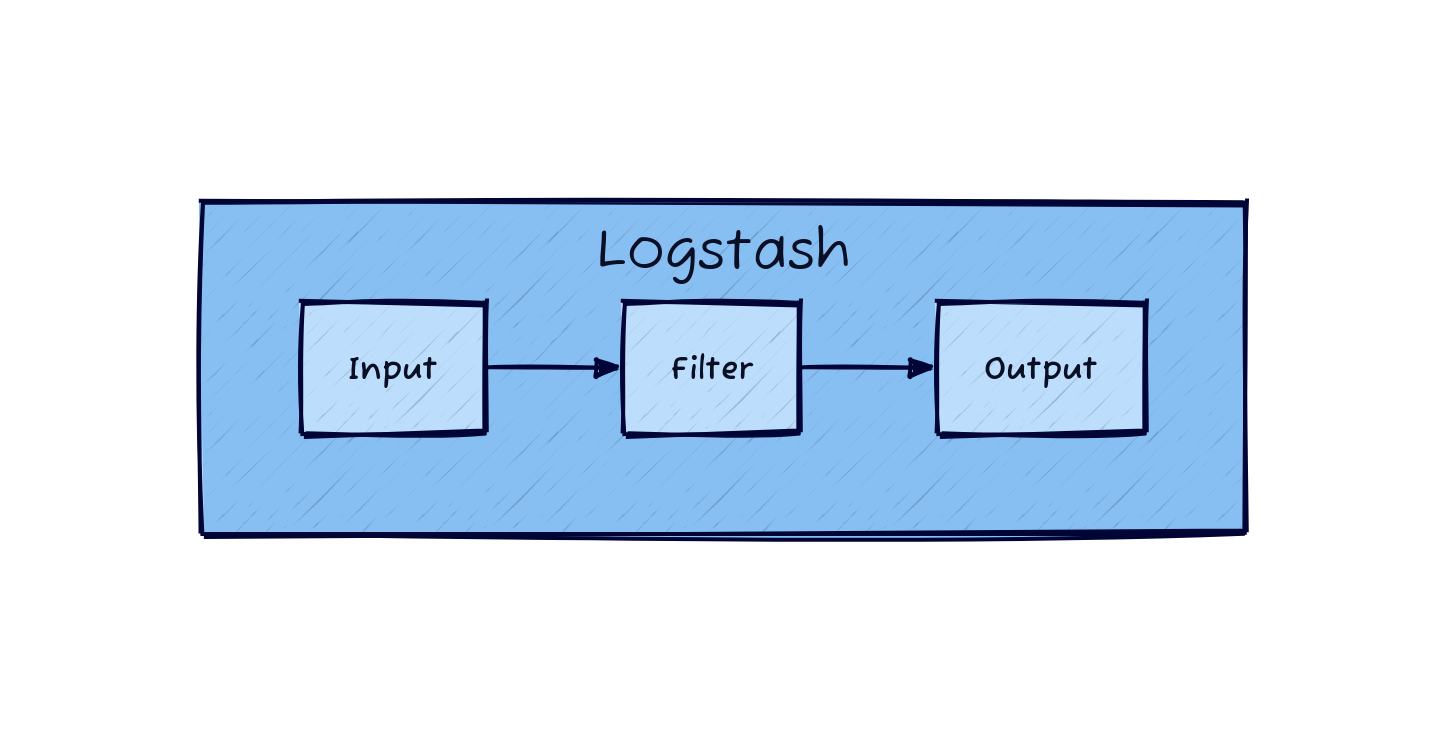
Figure 9: Logstash 数据处理管道
Input、Filter、Output——几乎就是 rsyslog 的 Input、Ruleset、Action 的翻版。但 Logstash 拥有 rsyslog 难以企及的武器:极其丰富的插件生态,从 HTTP、JDBC、S3 到 Kafka,几乎可以接入任何数据源。它用 JRuby 编写,运行在 JVM 之上,虽内存开销巨大,但换来了数百个社区插件。
然而,JVM 的 GC 和内存占用在高并发下成了 Logstash 的致命伤。于是 Elastic 公司推出了 Filebeat——一个用 Go 编写的轻量级采集器,职责极其单一:读取文件,发往 Elasticsearch 或 Logstash。不做复杂过滤和转换,只做好一件事。
这便是云时代日志采集的第一条演化路径:重型处理端与轻量采集端分离。复杂的数据清洗和转换,留给后端集群,前端只负责可靠搬运。
Fluentd 走了与 Logstash 相似却不同的路。架构同为 Input → Filter → Output,但用 C+Ruby 实现,比 JVM 上的 Logstash 轻量得多。2016 年成为 CNCF 毕业项目,一度成为云原生日志采集的事实标准。
但 Ruby 的 GC 和内存开销依然存在。于是 Fluent 社区推出 Fluent Bit——纯 C 编写,内存占用不到 1MB,定位是"轻量级转发器"而非"重型处理器"。演化路径与 ELK 如出一辙:采集端越来越轻,处理逻辑越来越靠后。终极形态是 Fluent Bit 只负责采集转发,所有过滤、清洗、结构化、富化都交给后端。
rsyslog 的 Action(直接写数据库、写文件)在云原生时代显得过重。云原生的理念是:先采集,后处理,再存储,按需查询,而非在采集点就决定日志的最终去向。
3.4. 系统层的革命:journald
如果说 ELK 和 Fluentd 从"应用层"解决问题,journald 则是从"系统层"发起的革命。
journald 是 systemd 的一部分,从内核引导阶段开始工作,捕获内核日志、系统服务日志、应用程序的标准输出和错误,以结构化、二进制、索引化格式存储在 /var/log/journal 下。journalctl 可按时间、服务单元、进程 ID、优先级精准过滤。
journald 与 rsyslog 的根本区别在于:日志被视为"系统的一等公民",而非"
文本文件"。每条日志携带丰富元数据( _PID 、 _BOOT_ID 、 _SYSTEMD_UNIT
等),查询时无需逐行扫描文本文件。
2013 年,Fedora 提出"No Default Syslog"变更,不再默认安装 rsyslog,转而以 journald 为默认日志方案。此后 Debian(第 12 版起)、RHEL 等主流发行版纷纷跟随。rsyslog 从"默认"变成了"可选"。
3.5. 应用层的绕行
有一条容易被忽视的路径:应用通过日志库(如 log4j、Python logging)直接写入文件,完全绕过 /dev/log 和 UDP 514。这意味着即使 rsyslog 配置再完备,也收不到这些日志。传统 syslog 守护进程作为"日志事实中心"的假设,在应用层的"选择性绕行"面前开始松动。
Filebeat 和 Fluent Bit 的崛起并非只因为更轻量——它们从根本上承接了这种去中心化的现实:哪里产生日志,就从哪里采集。直接 tail 文件,发往中心,闭环完成。即便在 journald 成为默认的系统中,Filebeat/Fluent Bit 也提供了直接从 journald 读取的插件(Filebeat 的 journald 输入、Fluent Bit 的 systemd 输入),保留完整元数据,发往 ELK 或 Loki。
3.6. 结构化的回报
当日志被结构化采集、集中存储之后,它的价值开始真正显现。Nginx 的 access log 就是一个典型例子:
log_format main '$remote_addr - $remote_user [$time_local] '
                '"$request" $status $body_bytes_sent '
                '"$http_referer" "$http_user_agent" '
                '$request_time';
这份格式定义看起来平淡无奇,但有了它,你可以知道:
- 主要用户的国家分布
- 用户的浏览器分布
- 服务使用时间分布
- 服务返回值分布
- 服务响应时间分布
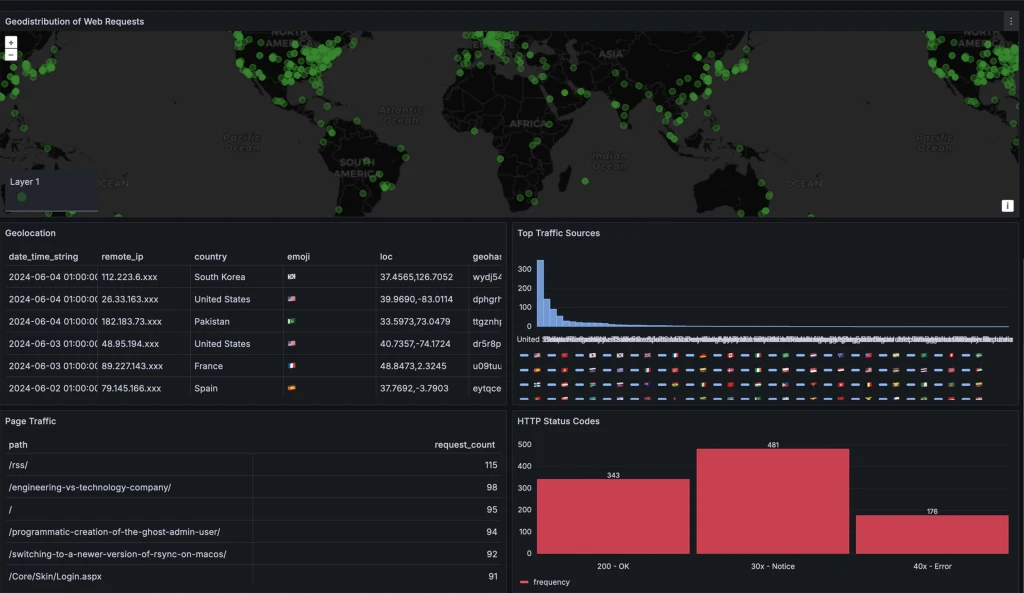
Figure 10: Nginx Access Logs Grafana Dashboard
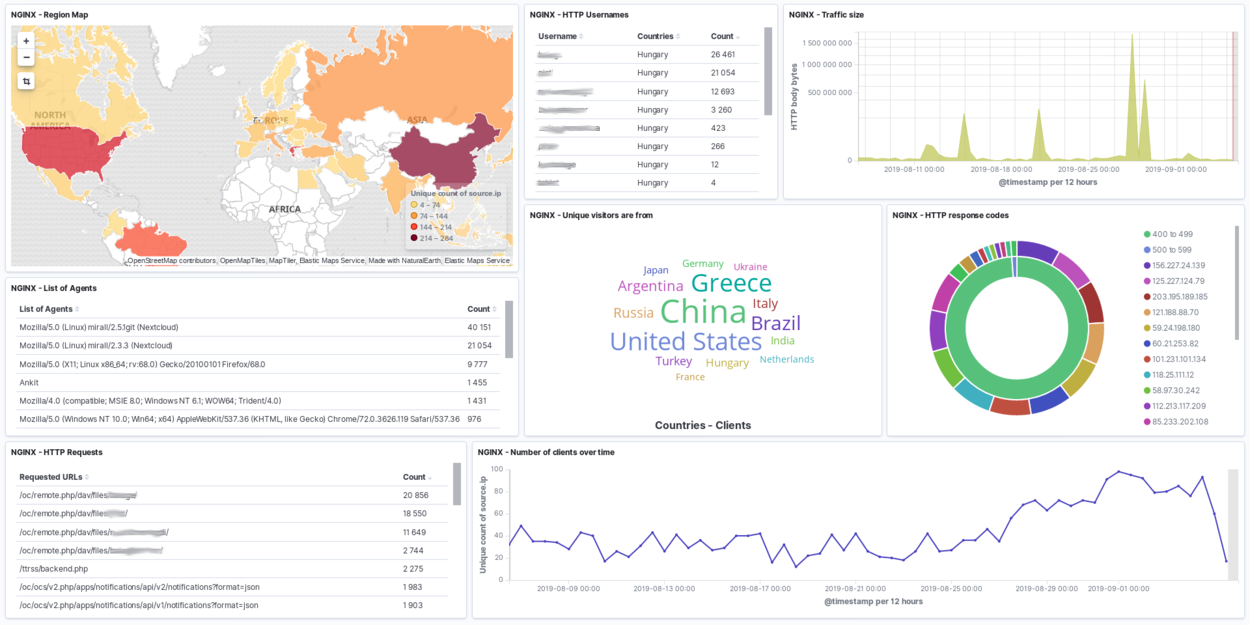
Figure 11: Nginx Access Logs Kibana Dashboard
从"查问题"到"看业务",日志的身份在悄然转变。
3.7. rsyslog 的遗产
rsyslog 的故事,是技术演进的一个缩影。它诞生于对传统 syslog 的不满,成长于对更可靠、更灵活、更结构化日志的追求,最终却在云计算、容器化、可观测性浪潮中被新的范式所取代。
但 rsyslog 没有消失。它依然是许多场景下可靠的选择——作为 journald 的补充,作为需要复杂转发规则时的专业工具。它从"默认"退居"可选",从"主角" 变成"老戏骨",在需要它的地方继续发光。对雷纳·格哈茨而言,=rsyslog= 是一个日志源,日志最终流向 Windows 上闭源的 WinSyslog,给他带来商业利益的也正是 WinSyslog,日志采集、传输、存储(数据库)、查看一应俱全。但云计算大潮下 Windows 操作系统就像巨浪下的礁石,任凭风吹浪打,它自岿然不动。不是不想动,实在动不了,直到 Windows WSL 出现一举翻盘。
正如雷纳·格哈茨在"自传"中所说:会让电子持续流动,做一些有意义的事。这里"有意义"大约等于"有价值"。他在云计算兴起之初就看到日志在 Windows 上的价值并攫取。相比云计算兴起后为避免 ELK 中 Elasticsearch 的价值被 AWS 白嫖,Elasticsearch 不得不改开源协议。
3.8. 半世纪的盲区:消费端的标准化
有一件事贯穿了整个日志史,但很少被直接说出来:系统日志和日志框架这么些年一直在解决的是如何生产、投递、过滤日志。消费端的标准化从来没有落地。
任何人都能写一个工具,把文本文件拆成自己想要的格式——每个人都是这么做的。这不仅是一个技术问题,也是一个认知问题:我们把"日志写出来了"等同于 "日志问题解决了",忘记了日志最终是要被人和机器读的。
整个处理链都需要标准化。不只是在生产端说"我用什么格式写日志",更是在消费端说"我怎样统一地读懂任何来源的日志"。OpenTelemetry 是第一次真正从消费端出发的标准化尝试——它不关心你怎么产生数据,它关心的是数据怎么被关联、被查询、被理解。
4. 第三幕:微服务的时代要求
微服务架构给日志系统提出了一个根本性的新要求:一个请求可能穿越几十个服务,传统的按机器、按服务割裂的日志,必须能串联起一个请求的完整链路。
一台机器宕了,查这台机器的日志。一个请求超时了——它是从哪个服务进来的?经过了哪些服务?在哪个服务耗时最长?这些问题的答案不在单台机器的日志里,而藏在跨服务的关联中。
4.1. 从日志到追踪
这个要求的第一个答案极其简单:给每个请求分配一个全局唯一的 Trace ID,这个 ID 在整个调用链中传播。每个服务在处理请求时,把 Trace ID 写入日志。这样,跨服务的日志就能通过 Trace ID 关联起来。
这个想法最早由 Google 在 2010 年的 Dapper 论文中系统阐述。Dapper 的贡献不只是 Trace ID 这个点子,而是它定义了一套完整的数据模型:Trace 是 Span 构成的有向无环图,每个 Span 代表一个逻辑工作单元(一个 RPC 调用、一个数据库查询、一个内部函数调用),包含操作名、开始时间、持续时间。
Dapper 之后,这个领域经历了标准化的博弈:OpenTracing 提供了统一的 API 规范,OpenCensus 从另一个方向切入,最终两者合并为 OpenTelemetry,成为可观测性的事实标准。
Jaeger 是 CNCF 毕业的分布式追踪系统,成为云原生架构下的第一选择。它可以 all-in-one 部署,也可以扩展为分布式系统:collector 接收追踪数据,可直接写入存储或通过 Kafka 缓冲防止数据丢失。
4.2. Trace-Log 关联
单纯追踪还不够——Trace 告诉你"什么慢了",但 Log 告诉你"为什么慢了"。两者必须关联。
OpenTelemetry 通过 Mapped Diagnostic Context(MDC)将 trace_id 和 span_id 注入每条日志。在 Java、Python 中可通过自动埋点完成。对于 JSON 格式日志,OpenTelemetry eBPF Instrumentation(OBI)可以在内核层面自动注入 trace context,无需修改应用代码。
这意味着:你可以在 Jaeger 里看到一个 Span 耗时 2 秒,然后直接跳转到对应时间段内该服务的所有日志,看到具体的错误信息。
4.3. 中心的意义
当追踪和日志需要关联查询时,一个看似简单的问题浮现了:日志存在哪里?
单机时代日志存在本地磁盘,多机时代可以存在中央数据库。但微服务时代," 中心"本身就是一个值得重新定义的词——它不是一台数据库,而是一层数据管道。
首先,日志怎么到中心?直接写存储的问题是微服务架构中日志产生速率不均匀——促销时段激增百倍,深夜几乎为零。存储必须按峰值规划,浪费巨大;后端抖动时采集器陷入重试甚至阻塞。Kafka 充当了削峰填谷的缓冲层:采集器只负责可靠写入,下游消费者按自己的节奏拉取。这是 Logstash 管道从进程内队列到分布式消息队列的物理分离。Elastic 的 beats 家族原生支持 Kafka 输出, rsyslog 也有 omkafka 模块。
日志集中后,需求从"把日志收上来"变成了"把日志关联起来":"订单服务返回 503 前后 5 秒内,支付服务和库存服务的日志是什么?" Trace ID 解决了关联的语义问题,但查询的执行还需要一个能跨服务检索的存储系统。传统的 Elasticsearch 能做到,但成本高昂。于是,存储后端的选择成了下一个核心问题。
4.4. 中心数据库演变
中心化存储的需求驱动了存储后端的一系列演变。
Jaeger 支持多种存储后端,恰好展示了这一演变的缩影:
- memory:开发测试用,重启即丢。
- Elasticsearch:最早的生产级存储,倒排索引提供全文搜索,曾是 Jaeger 默认存储。
- OpenSearch:Elasticsearch 的开源分支,在 Elastic 公司变更许可证后成为社区首选。
- ClickHouse:列式 OLAP 数据库,压缩比远超 ES,特定场景查询性能提升数十倍。
这条路线清晰反映了核心权衡:从"什么都能查"(全文搜索)到"查得够快且便宜"(列式存储)。
TDEngine 在这条路线上走得更远。它从一开始定位为"时序大数据处理引擎",而非通用搜索数据库。它基于一个洞察:日志查询的核心模式是"按时间范围 + 标签过滤 + 聚合分析",不是 TF-IDF 相关性排序。没有人需要知道"哪条日志和我的关键词最相关"——日志要的是"精确匹配",不是"最相关结果"。
TDEngine 做了激进优化:列式存储 + 高压缩比(存储成本约为 ES 的 1/5 到 1/10)、原生 SQL、自动分区与过期策略、超级表模型天然适配多服务采集。代价是不支持全文检索。
这正是"扬弃"的含义:否定了 ES 的通用搜索引擎路线,保留了时序数据管理的核心需求。实践中两者边界在模糊——ES 引入时序优化(TSDS),TDEngine 增强文本搜索——但方向差异已经明确:日志存储正在从"通用搜索问题"重新定义回"时序数据问题"。
TDEngine 不在 Jaeger 内置存储列表里。它不属于前文列出的那四个——memory、 ES、OpenSearch、ClickHouse——但 Jaeger v2 的 gRPC Remote Storage 接口补上了这个缺口。
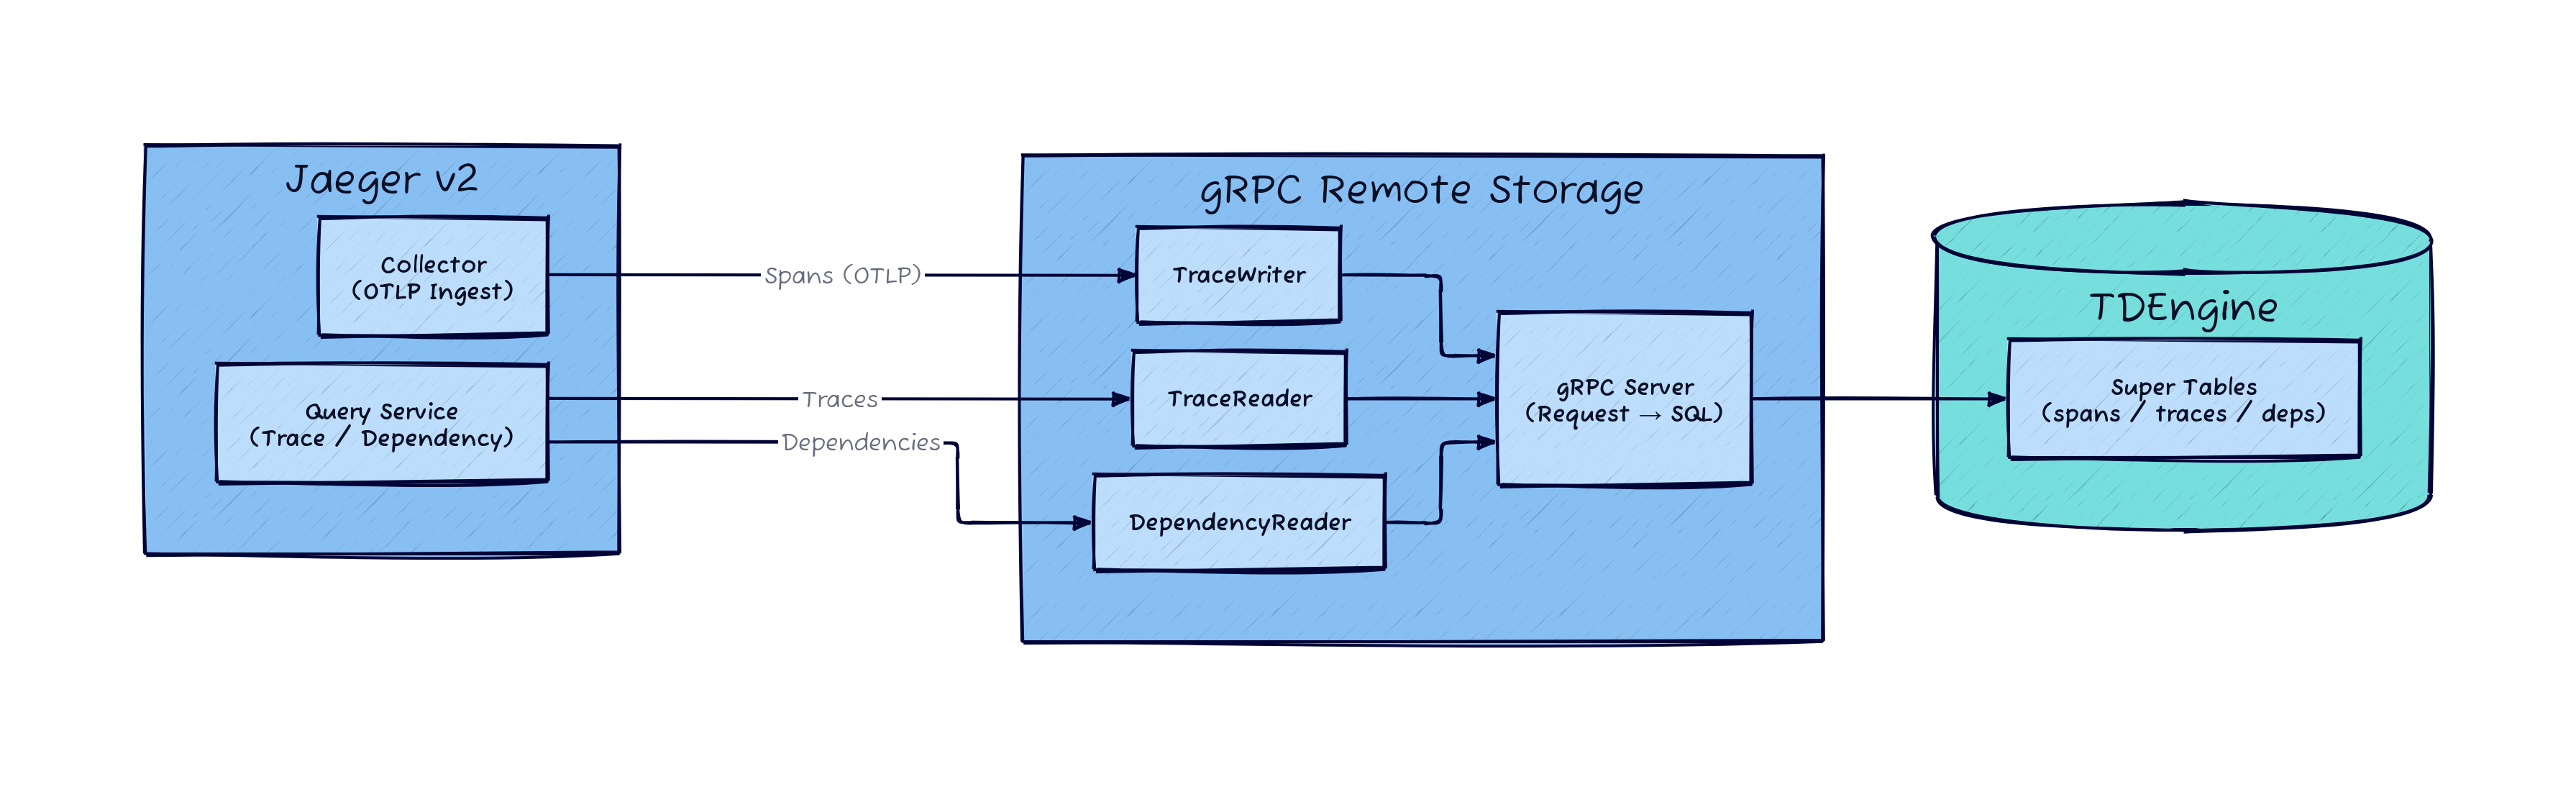
Figure 12: Jaeger v2 gRPC Remote Storage TDEngine
如图所示,这个接口定义了三组 gRPC 服务:TraceReader(读 trace)、
TraceWriter(写 trace,走 OTLP)、DependencyReader(读依赖图)。实现这组服务后,在 Jaeger 配置中声明 grpc 后端即可接入,不需要改 Jaeger 本体一行代码。Jaeger 项目提供了集成测试套件来验证实现合规性,通过后即可声称兼容。
对 TDEngine 而言这尤其自然:TDEngine 的超级表模型天然适配 Trace 数据的多服务采集,列式存储提供高压缩比,原生 SQL 可以直接基于 TraceID、时间范围、标签做精确查询——这正是日志存储从"全文搜索"回到"时序数据"这个方向的具体落地。参考实现可以从 jaeger/internal/storage/v2/grpc/ 的
handler 和 factory 出发,将 gRPC 请求映射为 TDEngine SQL。
4.5. 日志的关联
跨服务追踪、Trace-Log 关联、中心化管道、可扩展存储——微服务的每一项要求,最终都指向同一个方向:从"按来源组织"到"按请求组织"。
传统日志以进程为单位。你问"这个请求经历了什么",必须先知道它经过了哪些进程、在哪些机器上、大概什么时间——然后一处处翻。Tracing 把这个问题翻转了:以请求为单位,无论它穿越多少个服务,天然聚合在一起。
这不是对日志的替代,而是对日志的重新索引。
5. 第四幕:智能体时代
AI 智能体不是传统的"服务"。它是一个长时间运行的推理过程,涉及 LLM 调用、工具执行、多轮对话、RAG 检索、记忆读写等复杂环节。这对日志提出了全新的要求。
5.1. 新时代新挑战
传统的"一行日志记录一个事件"在智能体面前不够用了。智能体的每个"思考步骤"都是一个 Span——一次 LLM 调用、一次工具执行、一次检索、一次决策。日志不再是孤立的文本行,而是附着在 Span 上的事件(Span Event)。每条日志需要知道自己属于哪个 Trace、哪个 Span、哪次推理轮次。
智能体日志的新挑战:
- Trace Context 的跨进程传播:微服务时代 trace context 通过 HTTP Header 传播,每个框架都原生支持。但智能体的工具调用往往以子进程方式运行(MCP stdio transport),HTTP Header 不复存在。环境变量成为唯一的传播通道——相当于命令行的"HTTP Header"。大多数日志系统没有为此设计,链路极易断裂。
- 嵌套结构与动态 Schema:Agent Trace、Tool Call、RAG 检索结果、Prompt 和 Reasoning 具有嵌套结构,Schema 动态变化,不能简单拍平。
- 决策路径的可观测性:需要记录每次工具调用的输入参数、候选方案及选择理由。
- 会话级别的上下文:智能体的日志天然按"会话"组织,需要支持按会话 ID、用户 ID 等维度检索。
- 从黑盒到白盒:智能体的行为复杂且非确定性,日志分析成为评估智能体可信度的必要手段。
5.2. clog:Context-Aware Logging
clog 1是一个 Go 的 context-aware logging包。它的核心判断是:智能体时代的日志必须是上下文感知的,而上下文感知的第一步,是让 Trace ID 和 Span ID 自动附着在每一条日志上,不需要开发者手动搬运。
5.3. 基础用法
入口处埋好 span,后续所有日志自动携带上下文:
span, ctx := clog.StartSpanFromContext(ctx, "LLMCall")
defer span.Finish()
clog.Info(ctx, "calling GPT-4", "prompt_tokens", 1024)
这条日志自动带上 trace ID、span ID 和 labels,同时写到 slog logger 和活跃 span。开发者不需要关心 trace 怎么传——它在 context 里自动流淌。
5.4. 跨进程传播:环境变量即 Header
单进程内传 context 只是第一步。智能体的工具调用往往跨越进程边界——MCP stdio transport 本质上就是 exec 一个子进程。HTTP Header 没有了,环境变量成为 trace context 的唯一传播通道。
clog 为此提供了 InjectToEnv 和 ExtractFromEnv:
// 父进程:将 span context 注入环境变量
span, ctx := clog.StartSpanFromContext(ctx, "tool_call")
restore := clog.InjectToEnv(span)
defer restore()
cmd := exec.Command("mcp-tool")
cmd.Env = os.Environ()  // 携带 CLOG_TRACEPARENT
cmd.Run()

// 子进程(mcp-tool):自动从环境变量恢复 trace
span, ctx := clog.StartSpanFromContext(ctx, "tool_execution")
defer span.Finish()
// span 自动成为父 span 的子 span
StartSpanFromContext 内置了回退机制:当 context 中没有父 span 时,自动检查环境变量中的 CLOG_TRACEPARENT(W3C Trace Context 格式)。这意味着子进程不需要显式调用 ExtractFromEnv——直接调用 StartSpanFromContext 即可,trace chain 自动延续。
对于不想污染全局环境变量的场景,TraceEnv 返回 KEY=VALUE 字符串数组,适合精确构造 cmd.Env:
cmd.Env = append(os.Environ(), clog.TraceEnv(span)...)
5.5. MCP 集成
对于 MCP 协议,TraceparentOf 返回 traceparent 字符串,可以直接注入到 _meta 字段:
if tp := clog.TraceparentOf(span); tp != "" {
    params.SetMeta(map[string]any{"traceparent": tp})
}
5.6. 可插拔后端与可视化
日志中心的可选性也很关键。智能体可能运行在各种环境中——本地开发机、云上容器、边缘设备,甚至完全离线。日志中心不能是强制的,应该支持多种输出目的地:本地文件、stdout、远程 OTLP 端点、以及"哪里都不去"的静默模式。日志的存储和查询后端也应该是可插拔的——Elasticsearch、Loki、或者简单的文件都可以。
日志中心可插拔设计体现在具体的 systemd service 上:想用某个后端,部署对应的 service unit 即可;不用了,停掉或卸载 service 即可。以 Jaeger 为例,它被打包为一个极简的 systemd user service
~/.config/systemd/user/dscli-jaeger.service
[Unit]
Description=Jaeger (dscli)

[Service]
Type=simple
ExecStart=%h/.local/bin/jaeger
Restart=no

[Install]
WantedBy=default.target
整个 service 只依赖一个单一二进制 jaeger ,可通过 go install 安装:
go install github.com/jaegertracing/jaeger/cmd/jaeger@latest
安装这个 service 就是"插",不需要时 systemctl --user disable
dscli-jaeger.service 再删掉二进制就是"拔"——没有复杂的配置、没有依赖泥潭。
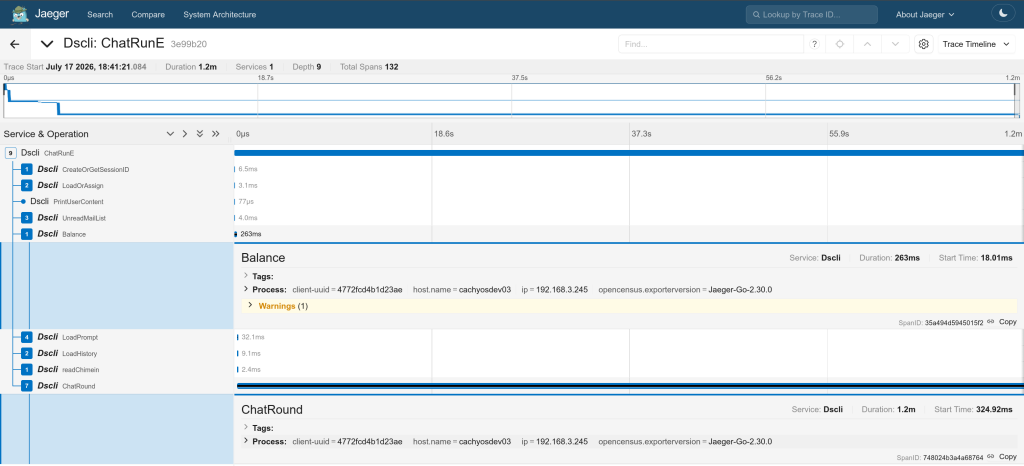
Figure 13: clog trace 在 Jaeger UI 中的展示
这张图展示了一个 clog trace 在 Jaeger UI 中的全貌:一次请求穿越多个组件,每个组件产生各自的 Span,所有 Span 通过 Trace ID 串联成一个完整的时间线。你能清楚地看到每个阶段何时开始、持续多久、有没有出错。
6. 尾声:日志的故事还在继续
从 /dev/log 到分布式追踪,从"写文件留个底"到"可观测性的三大支柱",日志的形态变了太多,但本质没变——它是系统对自身状态的诚实记录。
回头看这条演化之路:
BSD syslog 假设日志是本地行为,"写到一个文件里就行"。rsyslog 打破了这个假设,让日志可以在网络中被路由和处理,但它假设有一个系统守护进程接管一切。Docker 粉碎了这个假设。ELK 建立了新的中心化,但采集端越来越轻量。 Tracing 翻转了组织方式——从机器到请求。每个时代的工程师都以为自己站在终点,其实只是铺了一段路。
日志的故事远没有结束。可观测性追求的是"问任何问题",但追求本身就在不断重新定义什么问题是值得问的。日志从系统写给管理员看的诊断信息,变成服务写给开发者看的行为记录,再变成写给智能体看的历史上下文——下一个读者是谁?
正如雷纳·格哈茨 17 岁时那句话:"总有一天,我会轻松地与地球上任何地方的任何人协作。"他说这话时以为自己在说通信。回头看,他在说日志。
LLAP2
Footnotes:
"LLAP" 是 "Live Long and Prosper"(生生不息,繁荣昌盛)的缩写,出自《星际迷航》中瓦肯人的祝福语,也是 Rainer 的签名式结尾。