容器的故事
Table of Contents
Linux 容器的故事是一张水系图。
它的源头不止一处。1982 年 Bill Joy 在 BSD 里加的那个 chroot,1991 年贝尔实验室 Plan 9 的 per-process namespace,1999 年 FreeBSD 的 Jail——这是三条最远的支流,各自从不同的山出发。之后汇入的溪流越来越多: Solaris Zones、OpenVZ、cgroup、Mount namespace、PID namespace、User namespace——每一股水都不大,但合在一起,就成了河道。
到 2013 年 Docker 出现的时候,水流已经很急了。容器这条河有了自己的河床——namespace 做堤岸,cgroup 做闸门。再往后,Kubernetes 让河水学会了自己找路,OCI 和 CRI 给河道铺了标准尺寸的砖。
然后河水漫出了 Linux 的河岸。Windows 用 WSL 开了条支流,macOS 用 Containerization 挖了条渠道。容器不再是 Linux 独有的东西。
从 chroot 到 WSL Containers,从 FreeBSD 上的一个工具到三大操作系统的内置能力——这条河走了四十四年。它有泛滥,有改道,有干涸的支流,有突然涌出的暗河。
但方向始终是一个方向:让人们在共享的机器上安全、干净、方便地跑程序。
1. 容器思想溯源
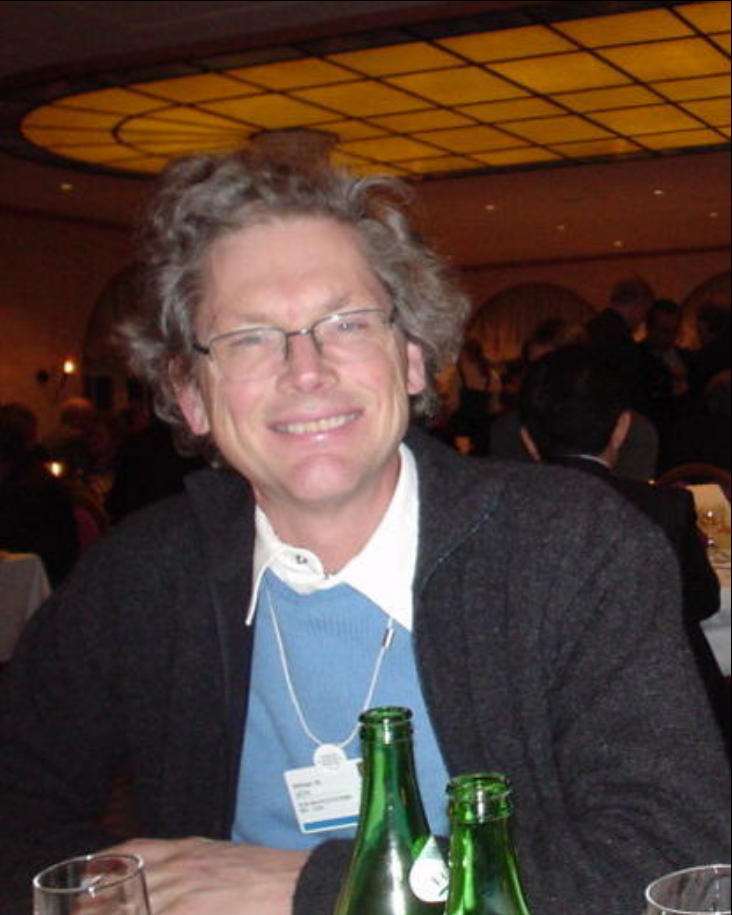
Figure 1: Bill Joy 2003
1982 年,Bill Joy 往 BSD 4.2 的代码里加了一个系统调用。他大概没想过四十年后,这东西会变成一项万亿美元产业的基础设施。那个系统调用叫 chroot——把进程的根目录锁定在指定目录下,让它看不到文件系统的其余部分。
动机很实际:测试安装程序、构建软件包、给 FTP 用户一个受限的访问环境。那时没人管它叫"容器",它只是一个工具。
但隔离的种子已经埋下了。
1.1. Jail 的诞生
1991 年,AT&T 贝尔实验室的安全研究员 Bill Cheswick 遇到了一个问题。他想观察黑客在攻入系统后的行为,又不希望黑客真的搞破坏。他搭了一个蜜罐——一台看似真实的系统,实际上被 chroot 限制住了。他在论文中提到用 Jail 来形容这种环境。
Figure 2: Bill Cheswick
Jail 这个词的巧妙之处在于,它的核心含义一直延续到今天:容器本质上是“限制”——让进程待在该待的地方,干该干的事。
这是从“技术工具”到“隔离概念”的第一次飞跃。
1.2. FreeBSD Jail——第一个真正的容器
1999 年,FreeBSD 核心开发者 Poul-Henning Kamp 收到一封陌生人的邮件。 Derrick T. Woolworth 做 Web 主机托管,不同客户需要不同版本的 Apache、 MySQL、Perl,被迫在机房堆满了一台台几乎空转的机器。Kamp 想了一下,发现 chroot 可以扩展成轻量级"虚拟机"——他动了手,项目叫 Jail。
2000 年 3 月,FreeBSD 4.0 带着 Jail 正式发布。
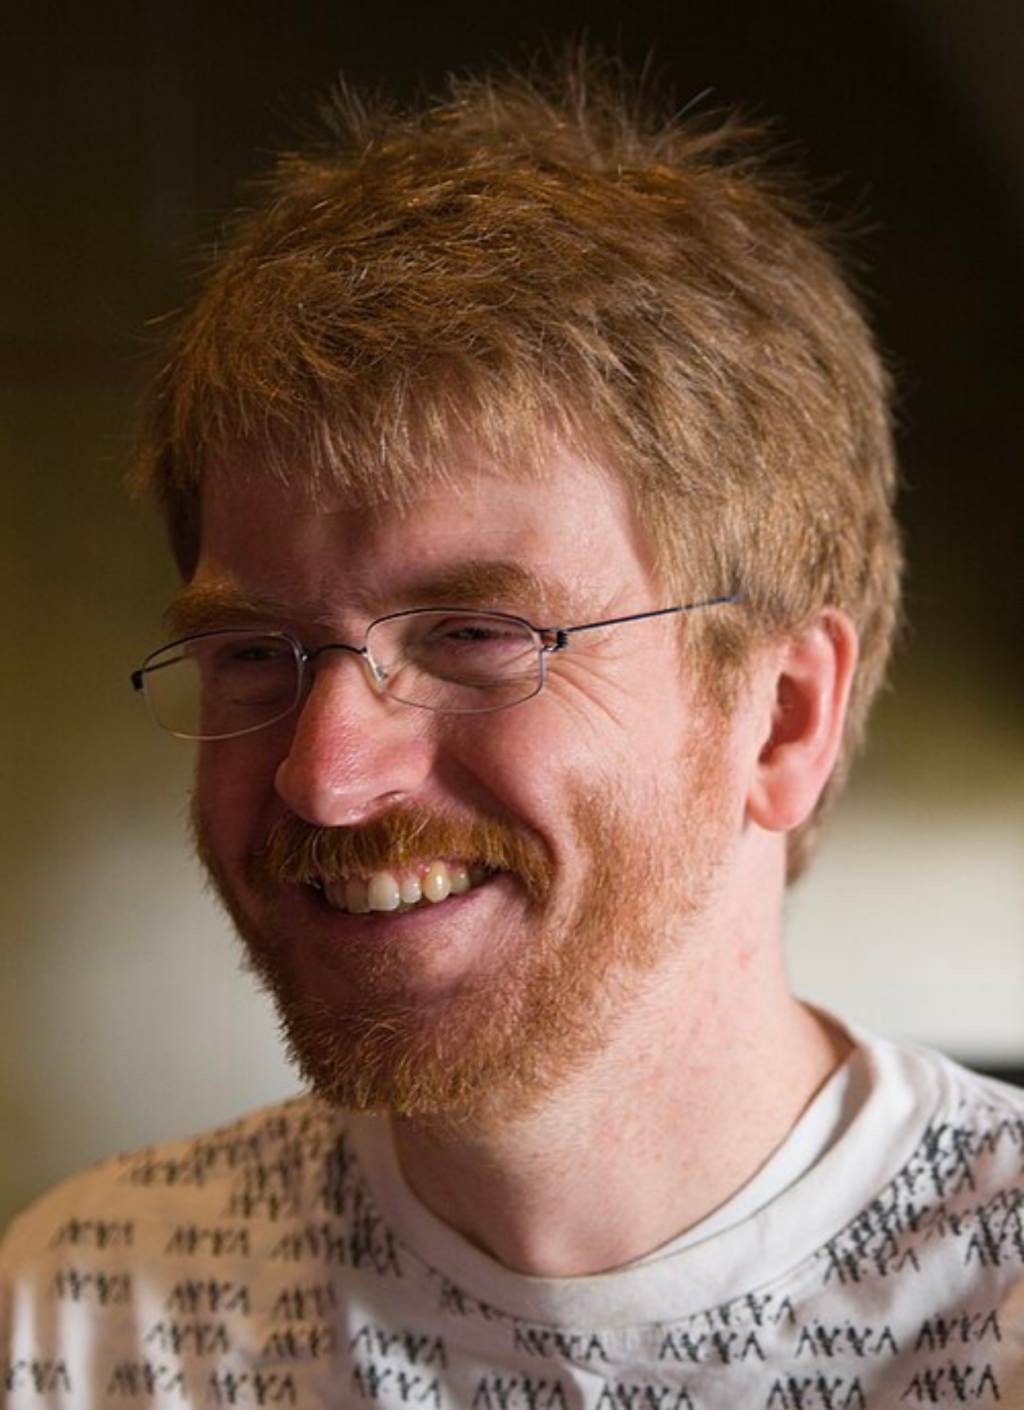
Figure 3: Poul-Henning Kamp 2013
Kamp 不是第一个想到隔离的人,但他做到了系统化。Jail 不只锁文件系统,它改了五件事:堵住 chroot 的逃逸口、限制进程可见性、定义 jail 里的 root 能干什么、让设备驱动知道 jail、给每个 jail 分配独立 IP。
其中最繁琐的是 root 权限——内核里所有写着"你是超级用户吗?"的地方都要逐个审。Kamp 趁这机会把所有权限检查统一成一个函数调用,后续其他项目也跟着省了事。
Jail 最出人意料的价值是"单向镜"——被囚禁的进程看不到外面,但外面的管理员能看到它。有人黑进了一个 jail,管理员从外面登录,喝着咖啡看攻击者在搞什么名堂——攻击者却不知道自己被围观了。Kamp 说这种猫捉老鼠的故事,"有些简直笑得不行"。
在今天看来这些很平常。但在 2000 年,这是公认的第一个真正的容器技术。
遗憾的是,这是 FreeBSD 的——不是 Linux 的。而历史选择了 Linux。
1.3. 企业方案:闭源的先行者
Solaris 10 在 2005 年发布了 Zones,内部代号"Kevlar"。Solaris 的工程师们做出了一个了不起的产品——完整的管理工具链和网络虚拟化,样样都有。 Sun 甚至拿 Jails 的显而易见特性去申请了专利,把 Kamp 的 SANE 论文列在参考文献里。"如果有人拿这些专利起诉你,"PHK 写道,"给我发邮件,我很乐意帮忙。" 但 Zones 是闭源的。
IBM 在 2007 年推出了 AIX Workload Partitions(WPAR),比 Docker 早了五年,甚至还支持热迁移和 Versioned WPAR——跑旧版 AIX 的容器。但同样,这是 IBM 的,不是你能在自己电脑上随便用的。
这两家公司的产品在功能上领先了时代,在生态上输给了时代。容器技术需要的不是强大的企业产品,而是一个谁都能参与的标准。
1.4. Linux 先驱们的挣扎
Linux 世界的先驱们走了一条更艰难的路。
2001 年,Jacques Gélinas 启动了 Linux-VServer 项目。2005 年, Alexander Tormasov 提出了 Linux 容器的三大核心要素——命名空间隔离、共享文件系统、资源隔离。他的同事 Kir Kolyshkin 带着 OpenVZ 走上了开源之路。
但 VServer 和 OpenVZ 都遇到了一个致命的问题:它们需要修改 Linux 内核的代码,加自己的补丁。Linux 主线的维护者们对这一切变化保持警惕。你改了内核,用户就得用你的内核——这等于把你和主流通用性割裂开了。
所以这些早期的 Linux 容器技术始终游离在主线之外,成了小众玩家的玩具。
2008 年,LXC 第一次发布的时候,它解决的就是这个问题——不需要改内核,使用已经进入主线的 namespace 和 cgroup。但那是第二部分的故事了。
2. 技术各支流
如果容器是一座房子,namespace 是墙——决定你能看到什么,cgroup 是水电表——决定你能用多少。没有墙,房子没有边界。没有水电表,隔壁可以把你家的电用光。
这两样东西都不是为了容器发明的。它们是一代代内核开发者为了解决"多租户共享机器"这个老问题,一点点攒起来的。
2.1. Plan 9:进程的名字空间
1990 年代,贝尔实验室的计算科学研究中心在做一个叫 Plan 9 的操作系统。这个项目始终没能取代 Unix,但它的一个想法后来被证明无比重要: per-process namespace——不同进程可以拥有不同的视角。
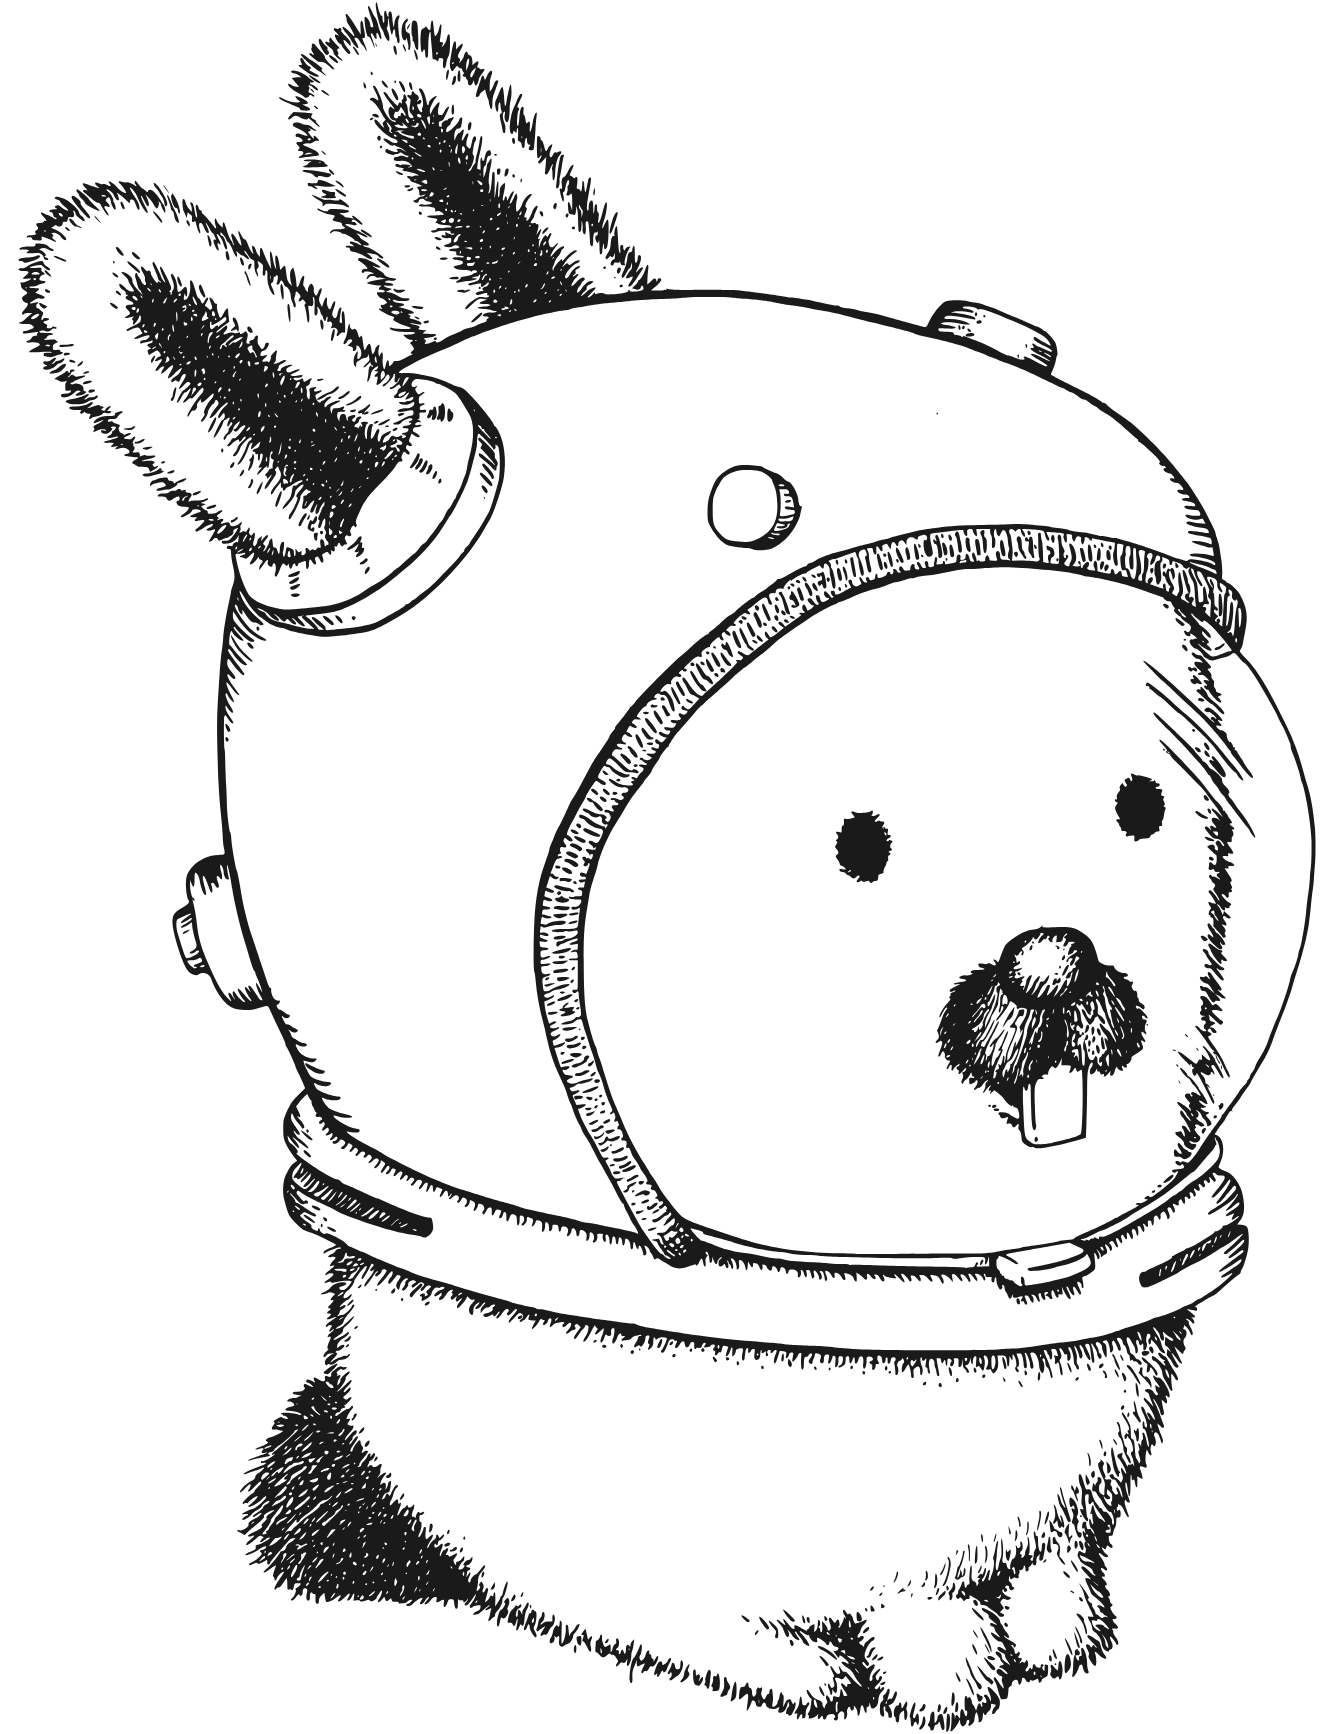
Figure 4: Glenda, Plan 9 穿太空服的吉祥物
按 Plan 9 的设计,每个进程看到的东西由它自己的 namespace 决定。这个想法在当时太超前了。File system namespace 是 Al Viro 后来做 Mount Namespace 时最重要的参照物——挂载点隔离、每个进程拥有不同的文件系统视图,这些在 Plan 9 里早已存在。
2.2. Mount Namespace——Al Viro
2002 年,Al Viro 把 Mount Namespace 放进了 Linux 2.4.19。内核源码里常量名叫 NEWNS——new namespace 的缩写。它做了一件事:让不同的进程看到不同的挂载点。
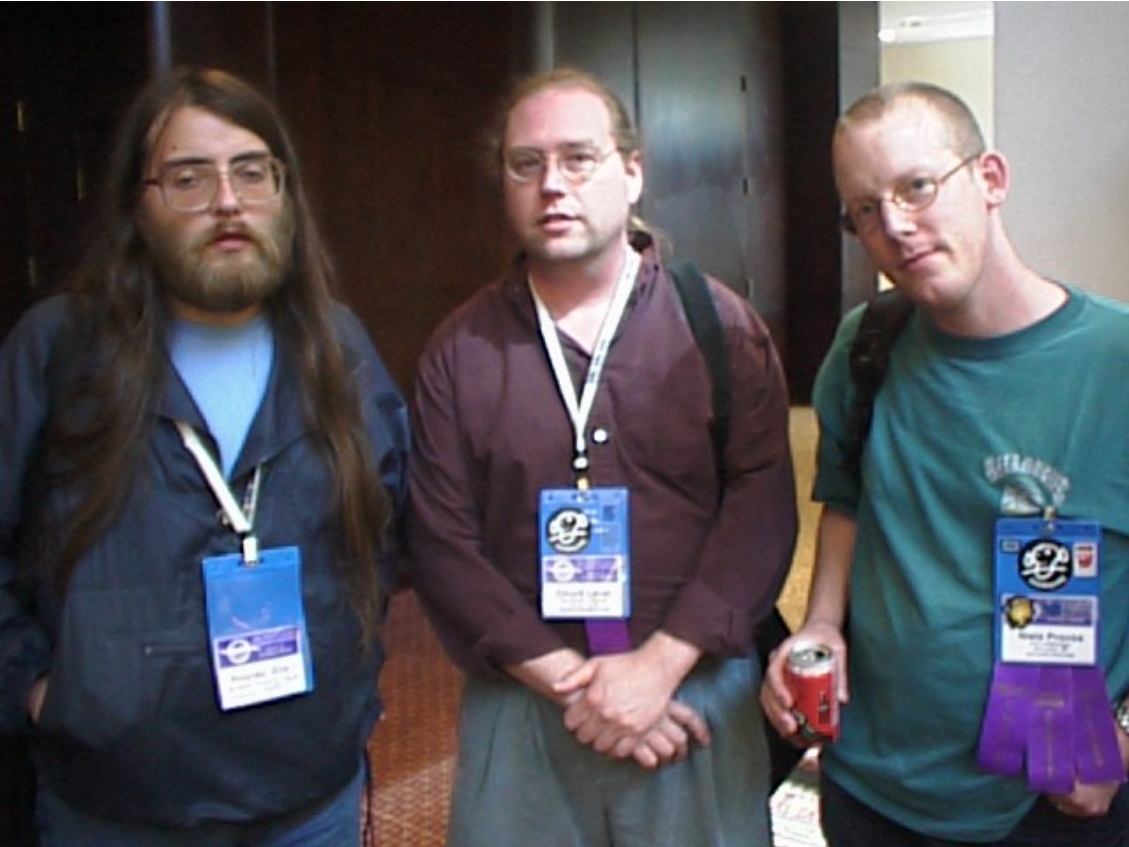
Figure 5: al viro, chuck, and niels who says linux and BSD don't get along? :-)
在今天看来,这是所有容器隔离的基石——进程 A 看到的/usr/bin 是宿主机的大目录,进程 B 看到的/usr/bin 却是自己容器里的小沙箱。但在当时,这只是 "给 chroot 加了个升级版"。
没有人意识到这只是开始。
2.3. 更多 Namespace——Eric Biederman
2006 年是 Linux 隔离技术的大年。Eric W. Biederman——Red Hat 的工程师——在这一年把 UTS(主机名)、PID(进程 ID)、IPC(进程间通信)三个 namespace 送进了 Linux 2.6.19。
PID namespace 是最关键的一个。进程在容器里看到的 PID 1 是自己内部的 init 进程,在外面可能是 PID 542。这意味着容器里杀掉的进程不会影响到宿主机。这听起来理所应当,但在 2006 年,这是革命性的——它意味着一个隔离的进程环境真的可以"像一台独立机器"了。
2008 年,Biederman 又送上了 User Namespace——把用户 ID 也隔离了。容器里你是 root,宿主机上一看只是个普通用户。
User Namespace 是工具中最难的一个,也是最危险的。你给了容器里的进程"假装自己是 root"的能力,但又不能让它真的获得宿主机的权限。Biederman 在这条悬崖边上走了很多年。
所有主要的 namespace 在 Linux 3.8(2012 年)全部完工。内核准备好了,只差临门一脚。
2.4. Cgroup——Google 工程师们的无名贡献
2006 年,Google 的 Paul Menage 和 Rohit Seth 启动了一个项目,最初叫 "Process Container"——进程容器。
这个名字后来惹了麻烦。"container"这个词含义太多,内核社区嫌它混乱, 2007 年改成了 cgroup——Control Group。控制组。这是一个更好的名字,因为它准确地说出了这东西做什么:限制、记账、隔离资源。
cgroup 不是隔离——它不给进程造墙。它做的是另一件事:让管理员规定"你这个进程最多用 1 个 CPU 核心、512MB 内存、100MB/s 磁盘 I/O"。没有 cgroup 的时候,一个出 bug 的进程能把整台机器吃光。有了 cgroup,它最多吃光它自己的那份。
2008 年 1 月,cgroup 随 Linux 2.6.24 进入内核。十一年后,cgroup v2 在 2018 年的 Linux 4.5 中合并。
2.5. 双剑合璧
namespace + cgroup = 容器。
这两者的结合不是某个人某一天"发明"的。它是渐进的、自然的融合——内核给了隔离的能力,内核也给了限制的能力,剩下的就是有人把它们组合起来,给一个好听的名字。
这个人在 2008 年第一次出现了。LXC——Linux Containers。它拿了已经处于内核里的 namespace 和 cgroup,包了一层用户态的工具,让普通人也能用了。
但它真正被世界认识,是在五年后。
3. 应用容器的成功
Solomon Hykes 没想过要做容器。他想做的,只是让别人更容易地部署网站。
Figure 6: Solomon Hykes
3.1. DotCloud 的诞生
2008 年,Hykes 从法国工程学校 EpiTech 毕业不久,在巴黎一家叫 SmartJog 的公司做服务器管理。每天重复的劳动让他和四个同事觉得无聊透了——配置环境、调参数、部署、改配置、再部署。
他们决定辞职创业。
这几个年轻人造了一个 PaaS 平台,名字叫 dotCloud。用户写代码,dotCloud 负责跑。为此他们需要一种轻量级的隔离技术——把不同用户的程序分开,又不能像虚拟机那样笨重。
他们造了一个容器引擎。
3.2. 没人关心的容器引擎
2008 到 2010 年,dotCloud 团队为这个引擎付出了常人难以想象的努力。他们甚至改了 Linux 内核的部分代码——因为彼时 namespace 和 cgroup 还不成熟,缺了一些关键功能。
但大问题是:没人关心。
dotCloud 的容器引擎是产品背后的引擎,产品本身是 PaaS。PaaS 市场在 2010 年前后已经挤满了玩家——Heroku、Engine Yard、Cloud Foundry。dotCloud 太小了,没人听说过。更致命的是,客户不敢把软件交给一群改过内核的陌生人。你说"我们改了 Linux 内核让它更安全"——正常的反应是:跑。
Hykes 后来回忆说,那几年最大的痛苦不是技术问题,而是"我们做出了好东西,但没人想要"。
3.3. 2013 年 3 月——Docker 开源
2013 年初,dotCloud 只剩下一个念头:反正产品卖不出去,不如把引擎开源,看看会发生什么。
2013 年 3 月,Docker 发布了。
它最初基于 LXC——那个 2008 年首次出现、用 namespace 和 cgroup 做隔离的工具。LXC 提供了容器的基础,Docker 在上面搭了三样 LXC 没有的东西:分层镜像(Union FS)、Dockerfile(声明式构建)、注册中心(镜像分发)。
"Docker 解决了什么问题?"——它解决的是"在我机器上能跑"这个问题。开发者把应用和依赖打包成一个镜像,扔给运维,运维说跑就能跑。没有环境差异,没有"但我的系统是……"的借口。一句话:"Build, Ship, Run Any App, Anywhere"。
社区疯了。
2013 年 10 月,公司更名为 Docker Inc.。通过 Y Combinator 孵化,融资 1100 万美元,投资人包括杨致远。2015 年,Docker 1.0 发布时,IBM、Red Hat、Rackspace 同时站台。
3.4. 成功的关键
Docker 没有发明容器。它做了三件比发明更难的事:
第一,它让容器变得可用。LXC 需要用户手动配置 namespace 和 cgroup, Docker 把这一切藏在了命令行后面。你跑一句 docker run,它就干了全部。
第二,它创造了镜像生态。Union FS 让镜像可以分层——一个 Ubuntu 基础层,一个 Nginx 层,一个配置层。每一层只存差异,方便分享。Docker Hub 让全世界的开发者可以互相分享镜像。这是 GitHub for containers。
第三,它在对的时机出现。2013 年,微服务架构刚开始流行,DevOps 运动正在兴起,云计算的普及让多租户共享成为刚需。Docker 恰好落在了所有趋势的交汇点上。
一句话:不是发明了容器,而是让容器变得人人可用。这个区别决定了历史的走向。
4. 容器标准化之争
Docker 的成功来得太快,快到了让整个行业不安的程度。
4.1. Docker 的单点控制——社区为什么需要标准
2014 年,Docker 已经是容器的事实标准。所有人都在用 Docker 的镜像格式,用 Docker 的 API,用 Docker 的命令行。Docker Inc.一家公司控制着容器的全部定义。
社区开始焦虑:"如果 Docker Inc.走错了方向怎么办?"
这不是杞人忧天。Docker 是开源的,但开源不等于开放治理。Docker Inc.拥有镜像格式的最终解释权,掌握着运行时行为的所有决策。一家创业公司决定几百万台服务器的运行方式——这个局面让很多人睡不着觉。
核心矛盾:开源不等于开放治理。
4.2. CoreOS 发难——AppC 与 rkt
2014 年 12 月 1 日,CoreOS 的创始人 Alex Polvi 和 Brandon Philips 发表了一篇博客,宣布 AppC(Application Container)规范和它的参考实现——rkt。
行业称之为"分手声明"。
CoreOS 本来是 Docker 的早期支持者,但他们逐渐发现 Docker Inc.的控制欲越来越强。Docker daemon 变得"肥胖"——一个巨大的、做所有事的守护进程。 CoreOS 要的是一个更安全、更可组合、遵循 Unix 哲学的容器运行时。
rkt 的设计理念和 Docker 截然相反:不需要 daemon,直接通过 CLI 调用,每个组件各司其职。
这场分裂不是技术分歧——它更深层。它问的是:一个行业基础技术应该由一家公司控制,还是由多方共同治理?
4.3. OCI 成立——六家公司的妥协
2015 年 6 月,答案出来了。
Docker、CoreOS、Google、Red Hat、IBM、Microsoft——六家恨不得互相拆台的公司坐到了一张桌子前。他们宣布成立 OCI——Open Container Initiative。
OCI 的使命很简单:容器运行时标准化 + 镜像格式标准化。
两个子项目:runtime-spec 定义"运行一个容器的标准是什么",image-spec 定义"一个容器镜像的文件应该长什么样"。
这是一个脆弱的妥协。Docker 不得不交出对自己核心技术的控制权,CoreOS 不得不承认 Docker 的镜像格式是事实标准。但双方都知道,不妥协的代价是行业分裂——就像当年 Unix 分裂成无数版本一样。
4.4. 运行时标准化——runc 的诞生
2015 年 12 月,Docker 把 libcontainer——Docker 运行时的心脏——捐给了 OCI。
Michael Crosby 是 libcontainer 的作者,也是 Docker 最核心的工程师之一。他把 libcontainer 变成了 runc——OCI runtime-spec 的参考实现。
这意味着什么?任何符合 OCI 标准的容器运行时都可以替代 Docker 的运行时。一家创业公司手里的大棒,变成了行业共享的工具。
4.5. 容器运行时拆解——containerd 的独立
2016 年 12 月,Docker 做了一个更彻底的决定:把容器执行层从 Docker daemon 中剥离出来。
这个独立的组件叫 containerd。它被捐给了 CNCF——不是 Docker Inc.,不是 OCI,是 CNCF。
架构变革:以前是 Docker daemon 做所有事,现在是三层——Docker(CLI 和 API)→ containerd(容器生命周期管理)→ runc(实际的容器运行)。
这个拆分的影响超出了 Docker 自己的想象。剥离之后,Kubernetes 可以直接调用 containerd,不用经过 Docker daemon。Nomad 可以。任何编排工具都可以。容器运行时从"Docker 的特权"变成了可替换组件。
4.6. CRI——Kubernetes 的容器运行时接口
2017 年,Kubernetes 社区又往前走了一步。他们定义了 CRI——Container Runtime Interface。
CRI 不是标准,是接口。任何实现了 CRI 的运行时都可以接入 Kubernetes: containerd 可以,CRI-O 可以,将来什么新的运行时——只要实现了一个 gRPC 接口就行。
这是容器标准化的最后一块拼图:运行时格式由 OCI 定,运行时接口由 CRI 定,编排框架不再绑定任何特定实现。
5. 系统容器的潜流
Docker 火起来的时候,很多人以为容器是 Docker 发明的。它当然不是。在 Docker 之前,另一条线已经走了很多年——系统容器。
5.1. LXC——第一个通用的 Linux 容器工具
2008 年,LXC 第一次发布。它是第一个大规模使用 cgroup 和 namespace 的工具,IBM 的人最早编写了它。
LXC 做的事情很简单:创建一个隔离环境,里面跑一个完整的 Linux 系统树。有 init,有 sshd,有多进程,像一台完整的服务器。
这和 Docker 完全不同。Docker 容器里通常只跑一个进程(你的应用),LXC 容器里跑的是整个操作系统。前者叫应用容器,后者叫系统容器。
LXC 在容器历史上扮演了一个特殊的角色:它既是 Docker 的启蒙老师(Docker 最初基于 LXC),又很快被 Docker 的光芒掩盖。很少人知道,Docker 当年的口号"Build, Ship, Run"——最初是在 LXC 上实现的。
2014 年,Docker 抛弃了 LXC,换成了自己的 libcontainer。对 LXC 来说,这是最好的"毕业礼"——学生超过了老师。
5.2. LXD——Canonical 的系统容器管理
Canonical——Ubuntu 背后的公司——看到了 LXC 的价值,也看到了它的不足。 LXC 能做系统容器,但缺少管理工具。你需要自己做网络配置、存储管理、安全策略。
LXD 是 Canonical 的答案——一个"containervisor"(容器管理程序)。它提供 REST API 远程管理、基于镜像的工作流、实时迁移。你从任何地方连接一台机器的 LXD 守护进程,远程创建、管理容器,就像操作本地一样。
LXD 的设计哲学和 Docker 完全不同:Docker 面向微服务,LXD 面向数据中心。一个容器等于一台物理服务器。
5.3. Incus——社区的分叉
2023 年 7 月,Canonical 做了一个决定:把 LXD 的治理收归内部。不再是社区项目,而是 Canonical 的官方产品。
社区的反应很快——分叉。
Stéphane Graber 是 LXD 的原首席开发者。当 Canonical 收走 LXD 的控制权后,他和社区的其他人决定把项目分出来。Aleksa Sarai——SUSE 工程师——创建了 Incus。Incus 从 LXD fork 出来,由原 LXC/LXD 的核心开发者维护。
一个开放治理的系统容器项目死了,一个社区驱动的系统容器项目活了。
5.4. systemd-nspawn——Lennart Poettering 的"Chroot on Steroids"
Lennart Poettering 不是容器工程师。他是 systemd 的作者。
systemd-nspawn 最初只是一个调试辅助工具——为了测试 systemd 在不同环境下的行为,而不影响宿主机。你给它一个目录树,它创建一个隔离的命名空间,在里面启动一个 systemd 实例。
但用着用着,大家发现这东西越来越像容器了。
它虚拟化文件系统、进程树和进程间通信。通过 machinectl 管理容器。可以启动完整的 OS 树。被形容为"打了类固醇的 chroot"。
和 LXC 不同,systemd-nspawn 不需要任何额外的配置框架。它利用 systemd 已有的基础设施,以一种极简的方式实现了系统容器。如果你已经在用 systemd,你已经有了一半的容器工具。
6. 应用商店的沙箱
Snap 和 Flatpak 不是容器。它们用 namespace、cgroup、seccomp 做沙箱隔离,但目标不是运行服务器程序——是安全地分发桌面应用。
隔离不是目的,分发才是。
6.1. Snap——为手机而生的孤儿
2014 年,Canonical 启动了一个叫 Snappy Ubuntu Core 的项目。它面向的不是服务器,不是桌面——是物联网和移动设备。Ubuntu Touch(Ubuntu 的手机系统)需要一个可靠的、能自动更新的应用分发机制。
当时 Ubuntu Phone 用的是 Click 包。Click 是给手机设计的——依赖隔离、事务性更新、签名验证。2015 年,Canonical 把 Click 的下一代演进改名为 Snap。不再是手机专属,而是"通用 Linux 包格式"。
但 2017 年,Ubuntu Phone 死了。
Snap 成了孤儿。一个为不存在的平台打造的技术。
大多数公司会砍掉这种项目。Canonical 没砍。Mark Shuttleworth 把它硬生生拽回了战场——服务器、桌面、IoT、边缘计算,到处推。Snap 的技术底子其实不差:squashfs 只读镜像、mount namespace 隔离、AppArmor 强制访问控制、 snapd 守护进程做自动更新。一个 Snap 包从构建到分发到更新,全链路自动化。
但它有一个致命问题:Snap Store 是专有的。Canonical 控制着服务器,控制着审核流程。这对开源社区来说,是一个无法接受的中间人。
Snap 成了一头孤兽——在服务器上和 deb 打,在桌面上和 Flatpak 打,在 IoT 上和所有对手打。打得很辛苦,但没死。
但 Snap 有一件事干得漂亮:MicroK8s。
MicroK8s 是一个完整的 Kubernetes 发行版——kube-apiserver、etcd、 kubelet、kube-scheduler、kube-controller-manager、kube-proxy、CNI,所有你叫得出名字的 K8s 组件,都打包进一个 Snap 沙箱里。安装就是一条命令:
snap install microk8s
然后你就有了一个单节点 K8s 集群。不需要单独部署 master 节点,不需要配置 worker join,不需要折腾证书和 RBAC。如果你亲手搭过一套生产级 K8s,你知道这有多麻烦。
一个为 IoT 手机系统设计的应用沙箱格式,装了一个数据中心编排系统。这是 2017 年 Canonical 推通用 Linux 包格式时完全没想到的用例。但运行得挺好。到 2026 年,MicroK8s 是开发者笔记本上最常见的 K8s 发行版之一——和 kind、minikube 并列。Snap Store 里最成功的 Snap,可能就是它。
6.2. Flatpak——另一种选择
2015 年,Red Hat 的 Alexander Larsson 启动了 xdg-app,2016 年改名 Flatpak。
它的技术路线和 Snap 很像——沙箱隔离、OCI 兼容的镜像格式、增量更新。但哲学完全不同:整个链条全开源。没有中央商店,Flathub 只是一个社区维护的仓库,任何人都可以运行自己的 Flatpak 仓库。
Flatpak 用的是 bubblewrap——一个基于 namespace 的沙箱工具,最初也是 Larsson 写的。它只做隔离,不做分发。分发是 OSTree 的事。
这是两条路的分水岭:Snap 相信"受控的体验",Flatpak 相信"开放的标准"。谁赢了不重要——重要的是,桌面应用沙箱这个品类,在容器成熟后自然而然地出现了。namespace 和 cgroup 的第二次生命。
6.3. LXD——系统容器的 Snap 实验
Snap 最有趣的用户,是 Canonical 自己的系统容器工具——LXD。
LXD 是一个系统容器管理器,一层在 LXC 之上的编排框架:REST API、远程管理、实时迁移、存储池。但它唯一的官方分发方式,是 Snap。
想用 LXD?先装 snapd,然后 snap install lxd。你用一个桌面应用沙箱格式,去装一个数据中心系统容器工具。
这有点讽刺:应用沙箱的格式,成了系统容器的载体。Canonical 把 LXD 当作 Snap 的旗舰用户——看,连 LXD 这么复杂的东西都能用 Snap 分发。但这同时把 LXD 和 Snap 绑定在了一起。遇到 Snap 的问题,就是 LXD 的问题。
6.4. Incus——挣脱 Snap
2023 年,Canonical 把 LXD 的治理收归内部。社区分叉了——Incus。
主导人物是 Stéphane Graber,LXD 的原首席开发者。他带着社区走,Aleksa Sarai 帮忙拉了项目。
Incus 做的第一件事:不再依赖 Snap Store。
原生 deb/rpm 包、静态链接的二进制文件、从 Alpine 到 Arch 的各种打包。 Incus 要证明,没有 Snap,系统容器也能活得很好。
然后社区往前走了一步。Graber 开始开发 IncusOS——一个专为 Incus 优化的微型操作系统镜像。它在虚拟机上启动,直接进入 Incus,不跑多余的东西。 IncusOS 的理念:你要的不是操作系统,你要的是系统容器。操作系统只是容器的载体,越薄越好。
这个故事有一个奇特的闭环:Snap 诞生自 Ubuntu Mobile,Ubuntu Mobile 死了,Snap 孤身存活,变成了 LXD 的唯一分发渠道。LXD 被分叉成 Incus,Incus 最终造就了 IncusOS——一个不需要 Snap 的操作系统。
LXD 当年用 Snap 分发自己,Incus 选择了自己的 OS。
6.5. 容器技术的又一次出走
应用沙箱是容器技术在发明者意料之外的又一次出走。
namespace 和 cgroup 被设计来隔离服务器进程——让多租户共享一台机器。但现在你用它来安全地安装桌面应用。这不是发明者的初衷,但这是技术成熟的标志:当一个内核原语可以被包装成这么多种产品形态时,它就不再属于发明者了。
Snap 和 Flatpak 告诉我们的,不是"容器可以做桌面应用"。它们告诉我们:当一套底层隔离技术成熟到操作系统自带时,它将成为所有问题空间的默认答案。不管你的问题是什么——服务器、桌面、手机、IoT——答案可能都是"隔离一个进程,给它一个干净的环境"。
这就是容器之后的世界。
7. 容器编排的进化
单个容器好管,但现实世界的应用从来不是一个容器。一个 Web 应用需要一个 Nginx、一个应用服务器、一个数据库、一个缓存。它们需要协调、发现、伸缩、容错。
这不再是容器的问题——这是容器集群的问题。
7.1. Fig/Docker Compose——多容器应用的定义
2013 年底,一个叫 Orchard 的小公司遇到了一个问题:他们用 Docker 部署复杂应用时,需要反复敲 docker run 命令,顺序不能错,参数不能漏,端口映射不能冲突。
他们造了一个工具叫 Fig——写一个 YAML 文件,定义你的应用由哪些服务组成,每个服务用什么镜像、暴露什么端口、连接什么网络。然后一条命令启动所有服务。
2014 年,Docker 收购了 Orchard。Fig 变成了 Docker Compose。
Compose 是"容器编排"这个概念最早的雏形。它不解决集群问题,但它第一次提出了"容器编排的核心是声明式描述"这个思路——你说应用长什么样,工具负责把它跑起来。
7.2. Cloud Foundry——PaaS 时代的容器先锋
2009 年,VMware 内部启动了一个秘密项目,代号"B29"。负责人是 Derek Collison。
Figure 7: Derek Collison
B29 的产物叫 Cloud Foundry——一个 PaaS 平台。开发者 push 代码,Cloud Foundry 负责把代码变成运行中的应用。为此它需要一个隔离组件——Warden。
Warden 是一个容器管理器。它在 Cloud Foundry 流行之前就提供了容器化的应用部署。当 Docker 在 2013 年出现时,Cloud Foundry 社区意识到 Warden 和 Docker 解决的是同一个问题。
"我们已经在用容器了,只是没叫它 Docker。" Cloud Foundry 自己后来走了很远——变成 Pivotal 的商用 PaaS,几经转手,在企业市场活了下来。但 Derek Collison 干了另一件事。
Cloud Foundry 的各个组件需要互相通信——轻量、快速、不挑语言。Collison 为此写了一个消息系统,叫 NATS。它简单到只有 publish/subscribe,至多一次投递,跑得飞快。
Collison 后来离开 VMware,创办了 Apcera。他继续用 NATS 做消息骨干。 2017 年 Apcera 卖给 Ericsson 后,他把 NATS 抽出来独立开源,创立了 Synadia。NATS 加入了 CNCF,银行用、车联网用、爱立信用。
然后到了 2026 年——AI 多 Agent 架构爆发,开发者发现他们面临的问题跟十年前的微服务一模一样:Agent 需要发现对等节点、跨边界交换消息、处理长耗时请求、感知彼此的上下线。Synadia 基于 NATS 发布了一套 Agent 协议,趁手得仿佛是为这个场景准备的。
Cloud Foundry 的遗产,不是 PaaS。是那个给 PaaS 组件传话的小消息系统,它在 AI 时代淬火重生。
2014 年,Google 宣布了一个开源项目:Kubernetes。
创始人是三位 Google 工程师:Joe Beda、Brendan Burns、Craig McLuckie。项目的内部代号叫"Project Seven of Nine"——《星际迷航》中的一个人物,后来成为容器编排之王。Kubernetes 的 Logo 有七条边——这个彩蛋来自 Seven of Nine。
Kubernetes 不是从零开始的。它源于 Google 内部的一个叫 Borg 的系统——Google 从 2003 年开始就用 Borg 管理全球数据中心里的几十亿个容器(Google 的容器是 Linux cgroup/namespace,不是 Docker)。Borg 证明了:一个系统可以管理一个数据中心的所有机器,自动调度工作负载、处理故障、管理资源。
Kubernetes 把 Borg 的教训公开化了。
但 Kubernetes 真正成功的原因不是它来自 Google。而是它做了三件关键的事:声明式 API(你说想要什么状态,它负责达到)、控制循环(不断检查当前状态和目标状态是否一致)、可扩展架构(任何人都可以写 Operator 扩展它的能力)。
7.3. 容器编排战争与统一
Kubernetes 不是唯一的容器编排工具。
Docker 自己有一套——Docker Swarm。Docker 声称"Swarm 模式下 Docker 本身就是一个编排工具"。Apache Mesos 也有一套。三家在 2015 到 2017 年间激烈竞争。
结局我们都知道:Kubernetes 赢了。
为什么?不是因为它技术最好。而是因为它生态最开放。Docker Swarm 绑定 Docker,Mesos 复杂到只有少数人能驾驭。Kubernetes 赢了标准战争——你不需要用 Docker,你有选择。
但这场胜利的前提是容器标准化已经完成——否则 OCI 和 CRI 不立, Kubernetes 无从兼容任何运行时。
8. Linux 容器走出 Linux
容器在 Linux 上成熟了。但故事没有在 Linux 上结束。
Windows 和 macOS——两个容器世界的局外人——各自找到了入局的方式。有意思的是,为这两条路铺路的人,都来自 Linux 容器世界的核心。
8.1. Windows: systemd 之父的微软之旅
2022 年,Lennart Poettering 加入微软。
Figure 8: Poettering 在柏林 2024
这个消息在 Linux 社区引起了一阵微妙的骚动。systemd 的作者——Linux 世界最有争议也最有影响力的基础设施开发者——去了 Windows 的阵营。
Poettering 不是容器工程师。他写的 systemd-nspawn 最初只是一个调试辅助工具,后来被形容为"打了类固醇的 chroot"。这东西虚拟化文件系统、进程树和进程间通信,越来越像容器。但它始终只是 systemd 生态里的一个工具——直到他去了微软。
WSL 在此之前已经走了很长的路。
8.2. WSL 1——兼容层
2016 年,微软宣布了 WSL 1——Windows 内核中实现了一个 lxcore.sys 驱动,通过 pico 进程提供者把 Linux 系统调用实时翻译成 Windows 系统调用。不需要虚拟机,不需要修改 Linux 内核。Windows 内核自己学会了说 Linux 的语言。
第一反应是——微软疯了吗?
但这只是一个兼容层。开发者用它来逃离 Cygwin 的噩梦,但它没有隔离任何东西。
8.3. WSL 2——真正的 Linux 内核
2019 年,WSL 2 换了一种思路——在轻量级虚拟机上跑一个真正的 Linux 内核。性能大幅提升,文件系统兼容性接近 100%,可以 apt install 任何东西,可以跑 Docker。
WSL 2 不是容器,它是一台虚拟机。但它为容器铺平了道路:当 Windows 已经可以流畅运行 Linux 内核时,容器就是下一步的自然选择。
8.4. WSL Containers——2026
2026 年,这个"下一步"来了。WSL Containers(WSLC),一个内置的 Linux 容器工具。不需要安装 Docker,不需要配置任何东西。打开命令行输入 wslc,就可以创建和管理 Linux 容器。
微软官方特别澄清:WSL Containers ≠ WSL 3。这是一个独立的功能,不是 WSL 2 的替代,而是在 Windows 上运行容器的本地方案。
Poettering 加入微软四年后,他把 systemd 带到了 WSL 里。一个完整的 systemd 在 Windows 上的 Linux 子系统里运行——Linux 最核心的系统工具,成了 Windows 上管理 Linux 容器的基座。
8.5. macOS: Containerization
Windows 那边来了一个 Linux 基础设施的核心人物。macOS 这边也是。
Michael Crosby。他写了 libcontainer——Docker 运行时的心脏。他把 libcontainer 变成了 runc——OCI runtime-spec 的参考实现。他创建了 containerd——Kubernetes 最广泛使用的容器运行时。
没有他,这篇容器故事的很多章节都不会存在。
2019 年,他加入 Apple。没有人知道他去做什么。猜测很多,答案很少。
2026 年,答案出来了。苹果发布了 Containerization 0.1.0。
Swift 写的。用 Virtualization.framework 在 Apple Silicon 上跑 Linux 容器。每个容器在自己的轻量级虚拟机里运行。有专门优化的 Linux 内核,启动时间在亚秒级。每个容器可以分配独立 IP 地址,不需要端口转发。
在 macOS 上跑 Linux 容器不算新鲜事——Docker Desktop 一直在做。但 Containerization 是苹果自己的系统框架,不是第三方产品的包装。你能直接用系统 API 创建和管理 Linux 容器。
vminitd 是项目里的一个子项目——一个极简的 init 系统,作为 VM 的初始进程启动,通过 vsock 上的 gRPC API 与宿主机通信。项目管理 ext4 文件系统,管理 OCI 镜像,操作远程仓库。它还设计了一个 Linux 后端——用 cloud-hypervisor + KVM,同一个 vminitd 协议,宿主机上的语义完全一致。
版本号 0.1.0 是一个诚实的声明:还很新,源代码稳定性不保证。需要 macOS 26、Apple Silicon、Xcode 26。
但苹果认真了。
从 1991 年 Bill Cheswick 用 chroot 做蜜罐,到 2026 年 Windows 和 macOS 用户都能原生创建 Linux 容器——这条路走了三十五年。隔离技术从一个 BSD hacker 的工具变成了三大操作系统的内置能力。
9. 尾声
从 1982 年到 2026 年,四十四年。chroot 变成了 WSL Containers 和 Apple Containerization。
回顾这条线,我们能看见什么?
9.1. 44 年的演变主线
三条线从一开始就在交织:隔离技术(从文件系统隔离到完整的 namespace 虚拟化)、资源控制(从无到 cgroup v2)、编排调度(从单机 docker run 到 Kubernetes 管理全球规模)。
从一台机器上的一个 chroot 目录,到数千台服务器上的容器集群——隔离的单位从进程变成服务,管理的维度从单机变成集群。
9.2. 容器与虚拟机的融合
容器和虚拟机曾经是竞争对手。现在它们在融合。
AWS 在 2018 年发布了 Firecracker——一个用 KVM 虚拟机运行容器工作负载的微虚拟化方案。它把虚拟机的安全边界和容器的轻量级特性结合在了一起。
Kata Containers 做了类似的事:每个容器在一个轻量级虚拟机中运行。你得到的是容器的镜像和 API,背后是虚拟机的硬件隔离。
趋势很清楚:容器获得虚拟机的安全边界,虚拟机获得容器的启动速度。两者不再是对立面。
9.3. Wasm 容器——下一个运行时?
OCI 标准化的一个意想不到的后果是:它让容器运行时的概念超越了 Linux 进程。
WebAssembly——一种轻量级沙箱运行时——正在悄悄进入容器生态。WasmEdge、 Wasmtime 等项目在用 OCI 规范打包 Wasm 模块。
如果 Wasm 运行时能像 runc 一样接入 OCI,容器不再是"Linux 进程"的同义词。容器变成了一种更抽象的东西——一种"以标准格式打包、在隔离环境中运行"的通用概念。
9.4. 容器技术教给我们的
最后,容器技术不是一个技术故事,它是一个生态故事。
隔离不是目的,目的是让不同团队安全地共享同一台机器。
标准化的价值大于任何一家公司的技术优势。OCI 是行业对这个教训的正面回应。
开源不等于开放治理——这是 Docker 教会行业的最痛苦的教训。
最成功的项目,往往不是在技术上最领先的那个,而是在正确的时间解决了大多数人共同问题的那个。Docker 不是第一个容器,Kubernetes 不是第一个编排工具,但它们在正确的时间做对了一件简单的事情。
这大概是容器技术留给我们的最重要的遗产。